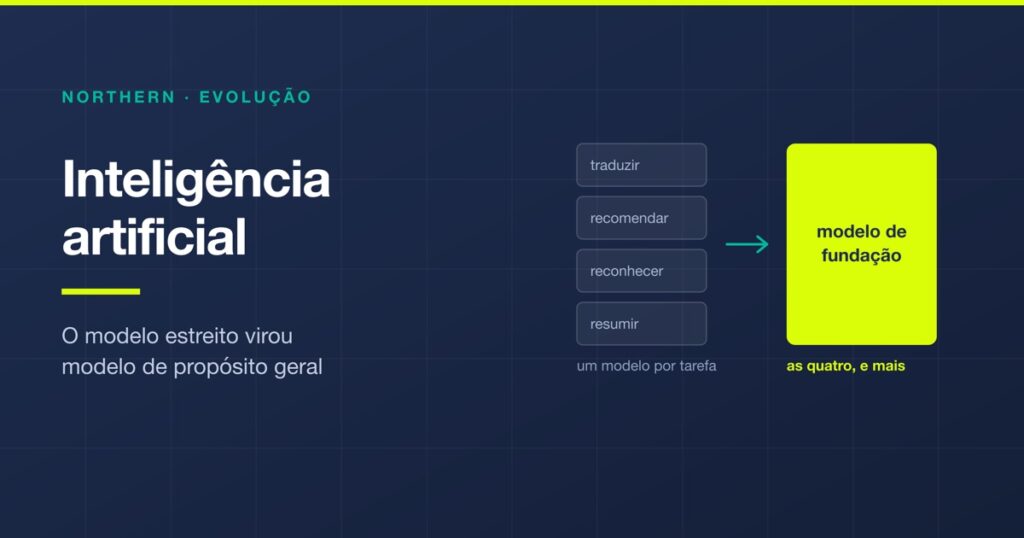
Durante décadas, a regra prática da inteligência artificial foi esta: cada modelo serve para uma coisa. Um modelo que reconhece rosto não traduz texto, um que traduz texto não recomenda produto, e tentar usar um fora do domínio em que foi treinado só produzia resposta ruim. Essa regra organizava tudo, inclusive a decisão de investir: você não comprava IA, você comprava um modelo para uma tarefa.
Essa regra caiu. E caiu rápido o bastante para que boa parte do que se escreveu sobre IA até 2022 esteja hoje descrevendo um mundo que não existe mais. Este texto refaz a linha do tempo até o presente e separa o que mudou do que continua valendo.
A linha do tempo em quatro fases
| Fase | Como o sistema “sabia” | Marco | Escopo de um modelo |
|---|---|---|---|
| Busca e regras | Humano escrevia as regras; a máquina calculava possibilidades | Deep Blue vence Kasparov (1997) | Uma tarefa, um domínio |
| Aprendizado | O modelo extraía padrões de dados rotulados ou de auto-jogo | AlphaGo vence Lee Sedol (2016) | Uma tarefa, um domínio |
| Modelos de fundação | Pré-treino em grande escala, depois adaptação por instrução | Transformer (2017), ChatGPT (2022) | Muitas tarefas, um modelo |
| Agentes | O modelo decide quando chamar ferramenta, buscar dado e repetir | Uso de ferramentas em produção (2023 em diante) | Tarefas em sequência, com estado |
Fase 1: força bruta e regras escritas à mão
O Deep Blue, que venceu Garry Kasparov em maio de 1997, é o exemplo canônico, e vale corrigir uma confusão comum: ele não aprendia nada. Combinava busca em árvore com uma função de avaliação ajustada à mão por enxadristas, e avaliava algo da ordem de centenas de milhões de posições por segundo. A inteligência estava na regra escrita pelo humano; a máquina contribuía com velocidade.
Isso define o teto da fase: sistemas assim são excelentes onde as regras são conhecidas e enumeráveis, e inúteis onde ninguém sabe escrever a regra. Ninguém consegue descrever em regras explícitas o que faz um rosto ser aquele rosto.
Fase 2: aprender a partir dos dados
A virada foi deixar o padrão emergir dos dados em vez de escrevê-lo. É o que machine learning faz, e o que o deep learning ampliou empilhando camadas de rede neural para aprender representações cada vez mais abstratas.
O AlphaGo, que venceu Lee Sedol em março de 2016, mostrou os dois mecanismos juntos: rede neural para avaliar posições, busca para explorar jogadas, e reforço por auto-jogo para melhorar sem professor humano. O documentário sobre a partida está disponível no YouTube e continua sendo a melhor introdução visual ao assunto.
O vídeo abaixo mostra o mesmo princípio num cenário mais legível: agentes aprendendo a jogar esconde-esconde e descobrindo, sozinhos, estratégias que ninguém programou.
Nesta fase, o escopo continuava estreito. Cada modelo tinha um domínio de validade definido pelos dados de treino, e essa era a limitação que definia o planejamento de qualquer projeto de IA. Também é a fase em que se popularizaram os tipos de inteligência artificial e as famílias de modelos que ainda hoje aparecem em material introdutório, quase sempre sem a fase seguinte.
Fase 3: transformers e modelos de fundação
Em junho de 2017, um artigo do Google chamado Attention Is All You Need apresentou o transformer, uma arquitetura que processa a sequência inteira em paralelo, ponderando a relevância de cada parte em relação às outras. O ganho prático foi permitir treinar em escala muito maior, e a consequência foi inesperada: modelos treinados apenas para prever o próximo pedaço de texto passaram a resolver tarefas para as quais ninguém os treinou.
É daí que vêm os LLMs (large language models, ou grandes modelos de linguagem) e o termo modelo de fundação: um modelo pré-treinado em escala, que serve de base para muitos usos em vez de um só. O processamento de linguagem natural, que era uma especialidade com modelos próprios, foi absorvido por eles. O lançamento do ChatGPT, em 30 de novembro de 2022, foi o momento em que isso saiu do laboratório.
Duas consequências importam mais que a novidade técnica:
- O escopo deixou de ser estreito. O mesmo modelo traduz, resume, classifica, escreve código e extrai dado de documento. A pergunta “qual modelo serve para esta tarefa?” virou “este modelo já resolve, ou preciso adaptá-lo?”.
- A conta inverteu. Treinar um modelo de fronteira saiu da faixa de qualquer organização que não seja um laboratório de IA. Usar um, por API, passou a custar frações de centavo por chamada. Antes você investia em treino e o uso era barato; agora o treino é proibitivo e o uso é uma linha de custo variável.
Sobre a segunda: é o ponto em que quase todo material anterior a 2022 erra de forma que muda a decisão. Textos daquela época recomendavam avaliar a capacidade de treinar modelos próprios. Hoje a decisão relevante é outra, e tem nome: construir, comprar ou customizar. A adaptação de um modelo de fundação, por instrução, por busca em base própria ou por ajuste fino, cobre a maioria dos casos empresariais sem treinar nada de zero. Do lado da criação de conteúdo e imagem, é a mesma fase que produziu a IA generativa, com exemplos que já são rotina.
Fase 4: modelos que usam ferramentas
A fase atual não vem de um modelo maior, vem de dar ao modelo a capacidade de agir: consultar uma base, chamar uma API, executar um passo, ler o resultado e decidir o próximo. Isso transforma uma resposta única num processo com vários passos e estado, e é o que se chama de IA agêntica.
A diferença prática para quem decide: nas fases anteriores, a IA entregava uma previsão e um humano executava. Aqui ela executa parte do processo. Isso muda o que precisa ser verificado, porque o erro deixa de ser uma resposta ruim numa tela e passa a ser uma ação errada num sistema.
O que não mudou: os dados continuam decidindo
A parte mais durável do assunto é também a mais antiga. Um modelo reproduz o que está nos dados, incluindo o que ninguém queria que ele reproduzisse. Um exercício que fizemos em fevereiro de 2021 continua ilustrando isso bem: buscar “cientistas famosos” no Google Imagens.

Entre as dez primeiras imagens, a única mulher era Marie Curie. Não por falta de outras: buscando “cientistas famosas”, no feminino, elas aparecem.

O problema não estava no algoritmo, estava no material com que ele aprendeu: um passado em que mulheres não eram registradas como cientistas. Os resultados dessas buscas mudaram desde então, e é justamente esse o ponto: o que o modelo devolve acompanha o que os dados dizem, não o que é verdade.
Com modelos de fundação isso não diminuiu, mudou de lugar. O viés agora vem de um corpus de treino que ninguém da sua empresa selecionou, e chega junto com a capacidade. Some-se a isso que o dado que você acrescenta continua sujeito à LGPD, e que a regulamentação avançou: o AI Act europeu entrou em vigor em agosto de 2024, com obrigações escalonadas por nível de risco ao longo dos anos seguintes, e serve de referência mesmo para quem não opera na Europa.
O que isso muda na hora de aplicar
A ordem das perguntas mudou junto com a tecnologia. O que funciona hoje:
- Comece pela tarefa, não pela ferramenta. Procure trabalho repetitivo, de alto volume e baixo valor por unidade, que produza texto ou dado estruturado. É onde o retorno aparece primeiro.
- Assuma que existe modelo pronto. A pergunta não é mais se dá para fazer, é se vale integrar e quem responde quando errar.
- Trate o custo como variável. Custo por chamada muda o cálculo: o projeto não termina no lançamento, ele passa a ter conta mensal proporcional ao uso. Vale fechar a conta com o método de ROI de IA antes de aprovar.
- Defina a verificação antes de ligar. Quanto mais o sistema age sozinho, mais isso importa. É a diferença entre piloto que vira produção e piloto que vira prejuízo, tema de por que a IA falha nas empresas.
- Corte o escopo do primeiro caso. Um caso estreito e verificável ensina mais que uma plataforma ampla, e o método de corte é o mesmo de qualquer produto: definir escopo.
Se você está começando pelo começo, vale ler o que é inteligência artificial antes desta linha do tempo. O resumo dela é curto: a IA parou de ser um especialista contratado para uma tarefa e passou a ser uma capacidade de propósito geral que se adapta. Isso torna a adoção mais barata e a supervisão mais importante, na mesma medida.
Perguntas frequentes
Quais são as fases da evolução da inteligência artificial?
Quatro. Busca e regras escritas à mão, cujo marco é o Deep Blue vencendo Kasparov em 1997. Aprendizado a partir de dados, com machine learning e deep learning, cujo marco é o AlphaGo vencendo Lee Sedol em 2016. Modelos de fundação, a partir do transformer em 2017 e do ChatGPT em 2022. E agentes, de 2023 em diante, quando o modelo passa a usar ferramentas e executar passos.
O Deep Blue usava inteligência artificial ou machine learning?
Não usava machine learning. O Deep Blue combinava busca em árvore com uma função de avaliação ajustada à mão por enxadristas, e avaliava centenas de milhões de posições por segundo. Ele não aprendia: a inteligência estava na regra escrita pelo humano, e a máquina contribuía com velocidade. Ele venceu Garry Kasparov em maio de 1997.
O que é um modelo de fundação?
É um modelo pré-treinado em grande escala que serve de base para muitos usos diferentes, em vez de ser treinado para uma tarefa só. O mesmo modelo traduz, resume, classifica, escreve código e extrai dado de documento. Isso quebrou a regra anterior de que cada modelo tinha um domínio de validade estreito, definido pelos dados de treino.
O que é um LLM?
LLM é a sigla de large language model, ou grande modelo de linguagem: um modelo de fundação treinado em grande escala sobre texto, capaz de resolver tarefas para as quais não foi especificamente treinado. Eles surgiram da arquitetura transformer, apresentada em 2017, e chegaram ao uso geral com o ChatGPT em novembro de 2022.
O que é o transformer e por que ele importa?
O transformer é a arquitetura apresentada em junho de 2017 no artigo Attention Is All You Need, do Google. Ele processa a sequência inteira em paralelo, ponderando a relevância de cada parte em relação às outras, o que permitiu treinar em escala muito maior. A consequência inesperada foi que modelos treinados apenas para prever o próximo pedaço de texto passaram a resolver tarefas para as quais ninguém os treinou.
Ainda é verdade que cada modelo de IA serve para uma tarefa só?
Não, e essa é a mudança mais importante desde 2022. Até os modelos de fundação, cada modelo tinha domínio de validade estreito, definido pelos dados de treino, e essa limitação organizava o planejamento de qualquer projeto de IA. Hoje o mesmo modelo cobre muitas tarefas, e a pergunta deixou de ser qual modelo serve para esta tarefa e passou a ser se o modelo já resolve ou se precisa de adaptação.
Vale a pena treinar um modelo próprio?
Para a maioria das empresas, não. A conta inverteu: treinar um modelo de fronteira saiu da faixa de qualquer organização que não seja um laboratório de IA, enquanto usar um por API custa frações de centavo por chamada. A decisão relevante hoje é entre construir, comprar ou customizar, e a adaptação de um modelo de fundação por instrução, por busca em base própria ou por ajuste fino cobre a maioria dos casos empresariais sem treinar nada de zero.
O que é IA agêntica?
É quando o modelo deixa de apenas responder e passa a agir: consultar uma base, chamar uma API, executar um passo, ler o resultado e decidir o próximo. Isso transforma uma resposta única num processo com vários passos e estado. A diferença prática é que o erro deixa de ser uma resposta ruim numa tela e passa a ser uma ação errada num sistema, o que muda o que precisa ser verificado.
O problema de viés nos dados foi resolvido pelos modelos novos?
Não, mudou de lugar. O modelo reproduz o que está nos dados, incluindo o que ninguém queria que ele reproduzisse. Com modelos de fundação, o viés passa a vir de um corpus de treino que ninguém da sua empresa selecionou, e chega junto com a capacidade. O dado que você acrescenta continua sujeito à LGPD, e o AI Act europeu, em vigor desde agosto de 2024, serve de referência de risco mesmo para quem não opera na Europa.
Por onde começar a aplicar IA no negócio hoje?
Pela tarefa, não pela ferramenta: procure trabalho repetitivo, de alto volume e baixo valor por unidade, que produza texto ou dado estruturado. Assuma que já existe modelo pronto e pergunte se vale integrar e quem responde quando errar. Trate o custo como variável, porque a conta é proporcional ao uso. Defina a verificação antes de ligar. E corte o escopo do primeiro caso: um caso estreito e verificável ensina mais que uma plataforma ampla.