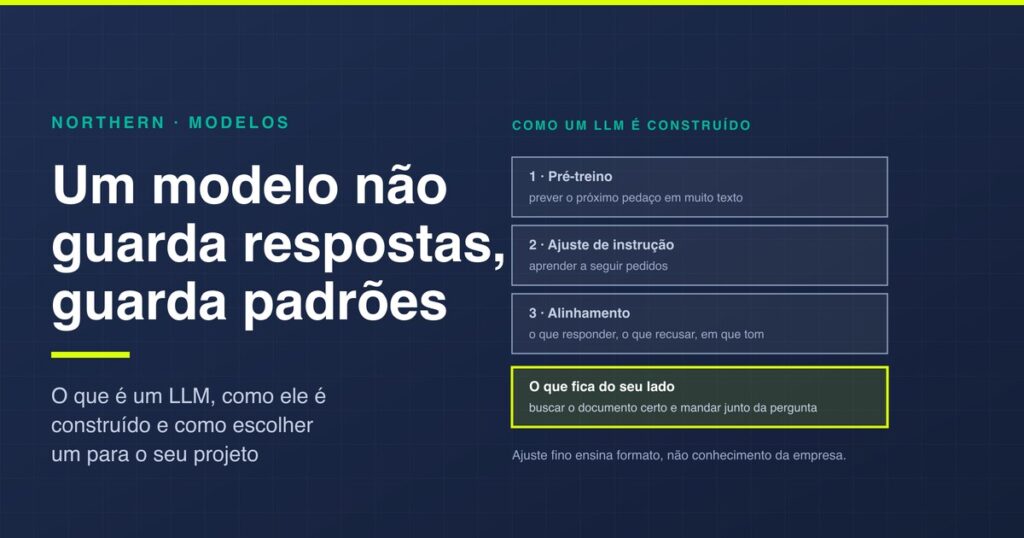
LLM é a sigla de modelo de linguagem grande, e a palavra que importa nela não é “grande”, é “modelo”. Um modelo não guarda respostas: ele guarda padrões extraídos de muito texto, em um monte de números ajustados durante o treino. É por isso que ele responde qualquer coisa e erra fatos específicos com a mesma naturalidade.
Este texto explica o que é um modelo, o que torna um modelo de linguagem grande, como ele é construído em três etapas, o que significam os números que aparecem nos nomes e como escolher um para um projeto de empresa.
O que é um modelo, afinal
Em aprendizado de máquina, modelo é uma função que recebe uma entrada e devolve uma saída, com o comportamento definido por parâmetros que foram ajustados a partir de exemplos. Ninguém escreveu as regras: elas foram deduzidas dos dados.
Isso vale para modelos simples e para os enormes. Uma regressão que estima preço de imóvel a partir de área e bairro é um modelo com poucos parâmetros. Um LLM é o mesmo princípio levado ao extremo, com bilhões deles, treinado para prever o próximo pedaço de texto. A diferença é de escala e de arquitetura, não de natureza.
A consequência prática mais importante: um modelo é uma compressão com perda do que viu. Ele generaliza bem e não guarda o original. Por isso pedir a um LLM que cite um número exato de um documento que ele “leu” no treino é um mau uso, e por isso o desenho correto é mandar o documento junto da pergunta.
O que faz dele um modelo grande
Três coisas crescem juntas: a quantidade de parâmetros, o volume de texto usado no treino e a computação gasta. O efeito prático não é o modelo “saber mais coisas”, é ele ficar melhor em generalizar: entende instrução complexa, mantém coerência em texto longo, lida com idioma e formato variados.
Existe um limite útil aí, e ele foi ficando mais claro nos últimos anos: modelo maior custa mais e responde mais devagar, e para muitas tarefas o modelo menor entrega o mesmo resultado por uma fração do preço. Classificar mensagem, extrair campo de documento e reescrever texto raramente exigem o modelo mais caro do catálogo.
As três etapas que criam um LLM
- Pré-treino. O modelo aprende a prever o próximo pedaço em um volume enorme de texto. É a etapa cara, feita por poucas organizações, e é ela que dá o conhecimento geral de mundo e de idioma.
- Ajuste de instrução. O modelo aprende a seguir pedidos, com exemplos de instrução e resposta. É o que transforma um completador de texto em algo que responde perguntas.
- Alinhamento. Ajuste final com preferência humana, definindo o que responder, o que recusar e em que tom. É a etapa que mais varia entre produtos e a que explica por que dois modelos parecidos se comportam de formas diferentes.
Uma quarta etapa acontece do lado de quem usa: o ajuste fino com dados próprios, que serve para ensinar formato e estilo específicos. Ele não é o caminho para injetar conhecimento da empresa, e é o erro mais comum de projeto: para conhecimento, o que funciona é buscar o documento certo e mandar junto da pergunta.
Os números que aparecem no nome
- Parâmetros, indicados por sufixos como 7B ou 70B, em bilhões. Dão uma ideia grosseira de capacidade e de custo para rodar, e não comparam bem entre famílias diferentes.
- Janela de contexto, quanto o modelo considera de uma vez, somando pergunta, documentos anexados e a própria resposta. É o número que decide se o seu contrato cabe na conversa.
- Versões mini, small e afins, que são modelos menores da mesma família, feitos para custar pouco e responder rápido.
- Quantização, uma redução de precisão dos números internos que faz o modelo caber em máquina menor, com perda pequena de qualidade. É o que viabiliza rodar modelo aberto em servidor próprio.
As famílias de modelo que não são LLM
Modelo de linguagem virou sinônimo de IA na conversa cotidiana, e isso esconde as famílias que resolvem a maior parte dos problemas de empresa com menos custo:
- Modelos tabulares. Regressão, árvores e conjuntos de árvores, treinados sobre as tabelas que a empresa já tem. São os melhores em previsão de demanda, risco de cancelamento e classificação de transação, e continuam ganhando de modelo de linguagem nesse terreno.
- Modelos de visão. Reconhecem objeto, defeito e texto em imagem. Convivem hoje com modelos multimodais, que fazem o mesmo pela linguagem e custam mais.
- Modelos de série temporal. Especializados em prever o que varia com o tempo, como consumo, estoque e carga.
- Modelos de recomendação. Ordenam opções a partir do comportamento de muitos usuários, e nada disso passa por linguagem.
- Modelos de embedding. Transformam texto em coordenadas numéricas para comparar significado. São a peça que faz busca por sentido funcionar, e trabalham junto com o LLM em qualquer sistema que responde sobre a base da empresa.
A regra prática: se o problema é sobre número e histórico, o caminho provavelmente não é um LLM. Se é sobre texto, documento ou conversa, provavelmente é.
Modelo aberto ou fechado
| Fechado, por serviço | Aberto, na sua infraestrutura | |
|---|---|---|
| Custo | por uso, cresce com o volume | fixo de máquina, compensa em volume alto |
| Dado | sai da empresa, com contrato regulando o uso | não sai, o que resolve caso sensível |
| Versão | muda quando o fornecedor decide | você congela a versão que testou |
| Esforço | quase nenhum para começar | infraestrutura, monitoramento e alguém responsável |
A linha da versão é a mais subestimada: sistema ajustado em cima de um modelo que muda sozinho pode se comportar diferente de um mês para o outro, sem que ninguém tenha alterado nada do lado de cá.
Como escolher um modelo
- Comece pelo menor que resolve. Teste a tarefa real no modelo barato antes de assumir que precisa do topo de linha. Em tarefa objetiva, a diferença costuma sumir.
- Meça com o seu material, não com exemplo genérico. Vinte casos reais, com o resultado esperado escrito, valem mais que qualquer comparativo publicado.
- Considere idioma. Desempenho em português varia mais entre modelos do que em inglês, e o comparativo internacional não captura isso.
- Verifique latência, porque em atendimento a diferença entre um e cinco segundos muda o produto.
- Decida sobre o dado antes, já que isso restringe a lista mais que qualquer critério técnico.
O que um LLM não é
- Não é banco de dados. Ele não guarda os textos do treino, guarda padrões, então citação exata sem fonte anexada é invenção.
- Não aprende com a sua conversa por padrão. O que parece memória é o histórico sendo reenviado a cada mensagem, ou um mecanismo de memória construído por fora.
- Não é determinístico. A mesma pergunta pode gerar respostas diferentes, e isso é ajustável, mas não desaparece.
- Não é um sistema. É uma peça. O que vira produto é o modelo mais busca na fonte certa, integração, registro e revisão, como está em IA generativa: como funciona e onde ela erra.
Para ver onde os modelos se encaixam entre as categorias da área, vale tipos de IA, e para a base conceitual, o que é inteligência artificial. Os usos que se pagam estão em exemplos de IA generativa, a conta em quanto custa criar uma IA, e o recorte antes do projeto em como definir o escopo do primeiro produto digital.
Perguntas frequentes
O que é um LLM?
É a sigla de modelo de linguagem grande: um modelo com bilhões de parâmetros, treinado para prever o próximo pedaço de texto a partir de um volume enorme de material. A palavra que importa na sigla não é grande, é modelo: ele não guarda respostas, guarda padrões extraídos do que viu. É por isso que responde sobre qualquer assunto e erra fatos específicos com a mesma naturalidade.
O que é um modelo em inteligência artificial?
É uma função que recebe uma entrada e devolve uma saída, com o comportamento definido por parâmetros ajustados a partir de exemplos, e não por regras que alguém escreveu. Uma regressão que estima preço de imóvel é um modelo com poucos parâmetros; um LLM é o mesmo princípio em escala extrema. Todo modelo é uma compressão com perda do que viu: ele generaliza bem e não guarda o original.
Como um LLM é construído?
Em três etapas. Pré-treino, em que ele aprende a prever o próximo pedaço em um volume enorme de texto, e é a fase cara, feita por poucas organizações. Ajuste de instrução, em que aprende a seguir pedidos, o que transforma um completador de texto em algo que responde. E alinhamento, com preferência humana, que define o que responder, o que recusar e em que tom, e é a etapa que mais diferencia produtos parecidos.
O que significam 7B, 70B e janela de contexto?
Os sufixos com B indicam bilhões de parâmetros e dão uma ideia grosseira de capacidade e de custo para rodar, mas não comparam bem entre famílias diferentes. Janela de contexto é quanto o modelo considera de uma vez, somando pergunta, documentos anexados e a própria resposta: é o número que decide se o seu contrato cabe na conversa. Quantização é a redução de precisão que faz o modelo caber em máquina menor.
Modelo maior é sempre melhor?
Não. Modelo maior custa mais e responde mais devagar, e em tarefa objetiva o menor costuma entregar o mesmo resultado por uma fração do preço. Classificar mensagem, extrair campo de documento e reescrever texto raramente exigem o topo de linha. A regra que funciona é começar pelo menor que resolve e só subir quando o teste com o material real mostrar diferença.
Ajuste fino serve para ensinar os dados da minha empresa?
Não, e esse é o erro mais comum de projeto. Ajuste fino serve para ensinar formato, estilo e padrão de resposta. Para conhecimento da empresa, o que funciona é buscar o documento certo e enviá-lo junto da pergunta, de modo que a resposta venha com fonte. Ajustar o modelo para tentar injetar conhecimento sai caro, envelhece a cada atualização de documento e continua permitindo invenção.
Modelo aberto ou fechado: qual escolher?
Fechado por serviço custa por uso, começa sem esforço e o dado sai da empresa, com contrato regulando o uso. Aberto na sua infraestrutura tem custo fixo, mantém o dado dentro e permite congelar a versão testada, ao preço de infraestrutura e de alguém responsável. A linha mais subestimada é a da versão: sistema ajustado sobre um modelo que muda sozinho pode se comportar diferente de um mês para o outro.
Como escolher um modelo para um projeto?
Comece pelo menor que resolve. Meça com o seu material, com vinte casos reais e o resultado esperado escrito, em vez de confiar em comparativo publicado. Considere o desempenho em português, que varia mais entre modelos do que em inglês. Verifique latência, porque em atendimento a diferença entre um e cinco segundos muda o produto. E decida antes o que pode ser enviado para fora, porque isso restringe a lista mais que qualquer critério técnico.
Todo modelo de IA é um LLM?
Não, e confundir isso encarece projeto. Modelos tabulares, treinados sobre as tabelas que a empresa já tem, continuam sendo os melhores em previsão de demanda, risco de cancelamento e classificação de transação. Existem ainda modelos de visão, de série temporal, de recomendação e de embedding. A regra prática: se o problema é sobre número e histórico, provavelmente não é um LLM; se é sobre texto, documento ou conversa, provavelmente é.
O LLM aprende com as minhas conversas?
Por padrão, não. Treino e uso são momentos separados, e o que parece memória é o histórico sendo reenviado a cada mensagem ou um mecanismo de memória construído por fora. Se um produto usa as conversas para treinar versões futuras, isso é uma decisão do fornecedor descrita em contrato, e é justamente o ponto a verificar quando o assunto envolve dado sensível.