Processamento de linguagem natural, ou PLN, é a área da inteligência artificial que faz a máquina lidar com a língua que as pessoas usam: interpretar, classificar, traduzir, resumir e também gerar texto e fala.
Quase todo material em português sobre o assunto descreve uma sequência de etapas manuais que era o padrão até 2018 e deixou de ser. Este texto mostra as duas abordagens, explica o que mudou e por que a antiga não é apenas mais trabalhosa: aplicada a um modelo atual, ela piora o resultado.
O que é processamento de linguagem natural
Linguagem natural é a que nasceu do uso humano, em oposição às linguagens formais, criadas para não terem ambiguidade. Português é linguagem natural. Uma linguagem de programação não é, e essa é justamente a diferença que cria o problema.
PLN cobre as duas direções, e vale corrigir uma definição comum que só menciona a primeira:
- Compreensão. Extrair sentido do que foi escrito ou falado: classificar um comentário, identificar do que a frase trata, encontrar nomes de pessoas e valores num contrato, decidir se um e-mail é spam.
- Geração. Produzir linguagem: responder, resumir, traduzir, transcrever áudio, redigir. Todo assistente que conversa faz as duas coisas, e é por isso que definir PLN apenas como extração de significado de texto escrito deixa metade do campo de fora.
PLN é um subcampo da inteligência artificial e, na prática atual, é feito quase inteiramente com machine learning: o comportamento é aprendido de exemplos, não escrito em regras.
Por que a língua é difícil para a máquina
A dificuldade não está no vocabulário, está na ambiguidade. A mesma sequência de palavras admite leituras diferentes, e o que decide qual vale é o contexto, que não está na frase.
O caso clássico é a vírgula que muda quem é o jantar:

A ambiguidade aparece em várias camadas ao mesmo tempo. “Manga” é fruta ou parte da camisa. “O policial prendeu o suspeito com o revólver” não diz de quem era a arma. Ironia inverte o sentido literal sem avisar. Negação, gíria, erro de digitação e emoji mudam a interpretação. E o mesmo texto significa coisas diferentes em contextos diferentes: “quebrou” é ruim numa avaliação de produto e ótimo num comentário sobre recorde.
O pipeline clássico, etapa por etapa
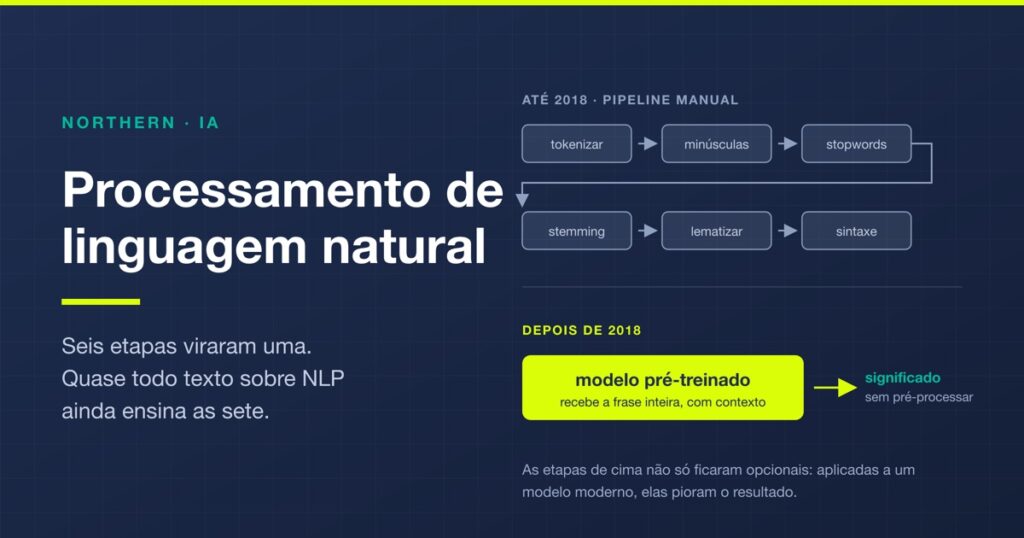
Até por volta de 2018, tratar texto significava passá-lo por uma sequência de transformações antes de qualquer análise. Vale conhecer, porque o vocabulário continua em uso e porque em alguns cenários simples ainda serve:
| Etapa | O que faz | Exemplo |
|---|---|---|
| Tokenização | Quebra o texto em unidades | “Adorei a tela.” vira [“Adorei”, “a”, “tela”, “.”] |
| Normalização | Passa tudo para minúsculas e remove pontuação | “Adorei” vira “adorei” |
| Stopwords | Descarta palavras tidas como pouco informativas | Saem “a”, “de”, “o”, “que” |
| Stemming | Corta a palavra até o radical, sem garantir palavra válida | “amigo” e “amiga” viram “amig” |
| Lematização | Reduz à forma de dicionário, respeitando a gramática | “tinha”, “tenho” e “tiver” viram “ter” |
| Análise sintática | Marca a função de cada palavra e a estrutura da frase | Identifica sujeito, verbo, objeto |
Cada etapa dessas descarta informação de propósito, para reduzir a variedade do texto e deixar a contagem de palavras mais tratável. E é aí que está o problema: o que se descarta às vezes é o que importa. Normalizar apaga a diferença entre “não gostei” e “NÃO GOSTEI!!!”. Remover stopwords apaga o “não” de “não recomendo”, invertendo o sentido. Stemming junta palavras que não deveriam se juntar.
A virada de 2018
Em 2017, um trabalho do Google apresentou o transformer, uma arquitetura de rede neural com um mecanismo de atenção que pesa a relação de cada palavra com todas as outras da frase ao mesmo tempo. Em 2018 vieram os primeiros grandes modelos pré-treinados construídos sobre ela, e o campo mudou de forma.
A diferença prática está em uma palavra: contexto. No modelo antigo, cada palavra virava um número fixo, sempre o mesmo. Num transformer, a representação da palavra muda conforme a frase. “Manga” recebe um vetor numa frase sobre camisa e outro numa frase sobre fruta, e o modelo aprendeu isso sozinho, lendo enormes quantidades de texto.
Dessa mudança saem três consequências que invertem a receita antiga:
- Pré-processar deixou de ajudar e passou a atrapalhar. Se o modelo usa a frase inteira para decidir o sentido, remover stopwords e pontuação retira exatamente as pistas de estrutura das quais ele depende.
- A tokenização mudou de natureza. Em vez de separar por espaço, os modelos atuais quebram em subpalavras, o que resolve o problema de palavra nunca vista: um termo desconhecido é montado a partir de pedaços conhecidos.
- Deixou de ser preciso treinar do zero. Parte-se de um modelo já treinado em muito texto e ajusta-se com uma quantidade pequena de exemplos do seu domínio. É o que tornou PLN acessível a quem não tem laboratório.
Os modelos de linguagem por trás dos assistentes atuais são a continuação direta dessa linha. São redes muito maiores, da família do deep learning, treinadas para prever a próxima unidade de texto em escala.
Como se faz hoje
As ferramentas acompanharam a mudança, e é fácil escolher a errada seguindo material antigo:
- NLTK continua existindo e é excelente para aprender os conceitos clássicos, mas hoje ocupa o lugar de biblioteca didática, não de ferramenta de produção.
- spaCy é a opção prática para as tarefas linguísticas tradicionais, com suporte a português e desempenho pensado para produção.
- Hugging Face Transformers é onde estão os modelos pré-treinados e o ecossistema em volta deles. É o ponto de partida padrão hoje.
- Para português, a boa notícia é que o cenário mudou: existem modelos treinados especificamente na nossa língua, sendo o BERTimbau o mais conhecido, além dos modelos multilíngues que já vêm com o português incluído.
Vale registrar o que ficou para trás: recomendações de corpus e ferramentas de mais de uma década atrás circulam até hoje em textos que parecem atuais, e parte dos endereços citados já nem responde. Ao pesquisar sobre PLN, olhe a data antes do conteúdo.
O que dá para resolver com isso
As aplicações mais úteis em empresa costumam ser mais modestas do que a conversa sobre o tema sugere:
| Aplicação | O problema que resolve |
|---|---|
| Análise de sentimento | Milhares de comentários e avaliações que ninguém lê. Classifica em positivo, negativo e neutro, e mostra do que se reclama |
| Classificação e roteamento | Chamados que chegam por texto e precisam ir para a fila certa sem alguém triando um a um |
| Extração de informação | Dados presos em contrato, nota fiscal e laudo: partes, prazos, valores e cláusulas viram campos estruturados |
| Busca semântica | Busca que encontra por significado e não por palavra exata, achando “cancelar assinatura” quando se digitou “quero sair do plano” |
| Resumo | Transcrições de reunião e atendimento que ninguém revisa por serem longas demais |
Duas dessas encostam em coisas que já existem por aqui: classificação e resposta automática são a base de um chatbot para empresas, e a análise de sentimento sobre histórico de atendimento costuma virar insumo de análise preditiva, para antecipar cancelamento.
Por onde começar num projeto real
A ordem que funciona é a inversa da que se costuma seguir. Em vez de escolher a técnica e procurar onde aplicá-la:
- Ache o texto que já está sendo ignorado. Campo de observação do formulário, histórico de chamados, transcrição de atendimento, avaliação de produto. Quase toda empresa acumula isso sem ler.
- Defina a decisão que mudaria. Saber que 40% das reclamações são sobre prazo só vale se alguém pode agir sobre o prazo. Sem decisão do outro lado, o resultado vira gráfico bonito.
- Comece com um modelo pronto. Antes de treinar qualquer coisa, rode um modelo pré-treinado sobre uma amostra e veja se o resultado já serve. Com frequência serve, e o projeto acaba aí.
- Rotule uma amostra pequena. Se precisar ajustar, algumas centenas de exemplos bem rotulados do seu domínio costumam bastar. Rotulagem é o custo real, e é ela que decide a qualidade.
- Meça com pessoas. Compare a saída do modelo com a classificação feita à mão numa amostra. Concordância abaixo do aceitável significa que o problema está mal definido, não que o modelo é ruim.
O segundo item é o que separa projeto de experimento, e pertence à definição de escopo: antes de perguntar como analisar o texto, é preciso saber quem vai fazer o quê com a resposta. É uma pergunta de negócio, e nenhuma biblioteca responde por você.
Perguntas frequentes
O que é processamento de linguagem natural?
É a área da inteligência artificial que faz a máquina lidar com a língua que as pessoas usam. Cobre duas direções: compreensão, que é extrair sentido de texto ou fala, como classificar um comentário ou encontrar valores num contrato; e geração, que é produzir linguagem, como responder, resumir, traduzir e transcrever. Definir PLN apenas como extração de significado de texto escrito deixa metade do campo de fora.
Qual a diferença entre PLN e NLP?
Nenhuma, são a mesma coisa em idiomas diferentes. PLN é a sigla em português para processamento de linguagem natural, e NLP é a sigla em inglês para natural language processing. Os dois termos são usados de forma intercambiável em material técnico brasileiro.
Por que a linguagem natural é difícil para a máquina?
Por causa da ambiguidade. Linguagem natural nasceu do uso humano, ao contrário das linguagens formais, criadas para não terem ambiguidade. A mesma sequência de palavras admite leituras diferentes, e quem decide qual vale é o contexto, que muitas vezes não está na frase. Manga é fruta ou parte da camisa, ironia inverte o sentido literal sem avisar, e uma vírgula pode mudar completamente quem é o jantar.
O que é tokenização?
É quebrar o texto em unidades menores para processamento. No pipeline clássico, tokenizar significava separar por espaço e pontuação, transformando uma frase numa lista de palavras. Nos modelos atuais a tokenização é por subpalavras, o que resolve o problema de palavra nunca vista: um termo desconhecido é montado a partir de pedaços conhecidos.
O que são stopwords, stemming e lematização?
São etapas do pipeline clássico de PLN. Stopwords são palavras consideradas pouco informativas, como artigos e preposições, que eram removidas do texto. Stemming corta a palavra até o radical sem garantir uma palavra válida, transformando amigo e amiga em amig. Lematização reduz à forma de dicionário respeitando a gramática, transformando tinha, tenho e tiver em ter.
Ainda preciso remover stopwords e fazer stemming?
Na maioria dos casos, não, e fazer isso pode piorar o resultado. Modelos baseados em transformer usam a frase inteira para decidir o sentido de cada palavra, então remover stopwords e pontuação retira exatamente as pistas de estrutura das quais eles dependem. Pior: remover stopwords apaga o não de não recomendo, invertendo o sentido do texto.
O que mudou no processamento de linguagem natural em 2018?
A chegada dos grandes modelos pré-treinados construídos sobre a arquitetura transformer, apresentada em 2017. A diferença prática é o contexto: antes, cada palavra virava um número fixo, sempre o mesmo. Num transformer, a representação da palavra muda conforme a frase, então manga recebe um vetor numa frase sobre camisa e outro numa frase sobre fruta. Isso tornou o pré-processamento manual desnecessário e permitiu partir de um modelo pronto em vez de treinar do zero.
Quais ferramentas usar para PLN hoje?
NLTK continua excelente para aprender os conceitos clássicos, mas hoje ocupa o lugar de biblioteca didática. Para tarefas linguísticas tradicionais em produção, spaCy é a opção prática, com suporte a português. Para modelos pré-treinados, Hugging Face Transformers é o ponto de partida padrão. Em português existem modelos treinados na nossa língua, sendo o BERTimbau o mais conhecido, além dos multilíngues.
Para que serve o processamento de linguagem natural nas empresas?
As aplicações mais úteis costumam ser modestas: análise de sentimento sobre milhares de comentários que ninguém lê, classificação e roteamento automático de chamados, extração de dados presos em contratos e notas fiscais, busca semântica que encontra por significado e não por palavra exata, e resumo de transcrições longas de reunião e atendimento.
Como começar um projeto de PLN?
Ache o texto que a empresa já ignora, como campo de observação de formulário e histórico de chamados. Defina qual decisão mudaria com a resposta, porque sem decisão do outro lado o resultado vira gráfico bonito. Rode um modelo pronto sobre uma amostra antes de treinar qualquer coisa, porque com frequência já serve. Se precisar ajustar, algumas centenas de exemplos bem rotulados costumam bastar. E compare a saída com classificação feita à mão numa amostra.