Deep learning é aprendizado de máquina com muitas camadas, e a consequência dessa arquitetura é o que importa: o modelo descobre sozinho quais características dos dados usar. Em aprendizado de máquina clássico, alguém precisa dizer ao modelo o que olhar. Em aprendizado profundo, ele extrai isso das camadas, e é por isso que funciona bem em imagem, áudio e texto, onde ninguém sabe listar de antemão o que importa.
Este texto explica como uma rede aprende, sem matemática, o que significa profundo, quais famílias resolvem o quê, o que essa abordagem exige de dado e computação, e quando ela é a escolha errada.
O que significa profundo
Uma rede neural é uma sequência de camadas de unidades simples. A primeira recebe o dado bruto, as do meio transformam essa informação passo a passo, e a última devolve a resposta. Profundo significa apenas isto: existem muitas camadas no meio.
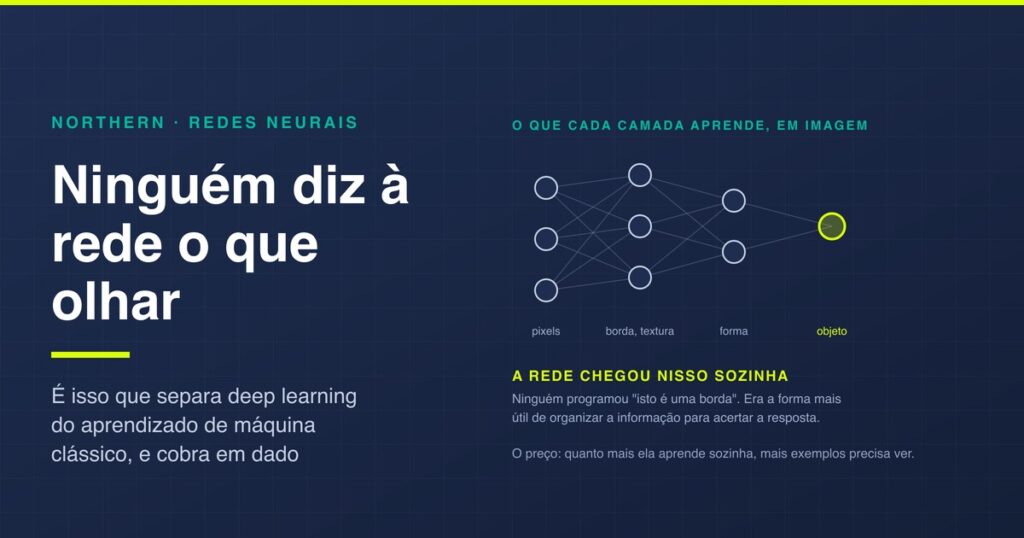
O ganho dessas camadas intermediárias é a construção progressiva de representação. Em uma rede que reconhece imagem, as primeiras camadas detectam borda e textura, as seguintes combinam isso em forma, e as últimas em objeto. Ninguém programou “isto é uma borda”: a rede chegou nisso porque essa era a forma mais útil de organizar a informação para acertar a resposta.
É essa capacidade que substitui o trabalho manual de escolher variáveis, e é também o que cobra o preço: quanto mais o modelo aprende sozinho, mais exemplos ele precisa ver.
Como uma rede aprende, sem matemática
- Chuta. No começo, as conexões entre unidades têm valores aleatórios, então a resposta é aleatória.
- Mede o erro. Compara a resposta dada com a resposta certa do exemplo.
- Distribui a culpa. Calcula quanto cada conexão contribuiu para o erro, andando da saída de volta até a entrada. É o passo que dá nome ao treino e o que tornou tudo isso viável.
- Ajusta um pouco. Cada conexão muda na direção que reduz o erro, em passos pequenos, controlados por um parâmetro de velocidade.
- Repete. Milhares ou milhões de vezes, com todos os exemplos passando várias vezes pela rede.
Duas consequências práticas dessa mecânica. O treino é caro e o uso é barato: treinar exige muita computação, e responder depois, pouca. E o resultado é opaco: o conhecimento fica distribuído em milhões de valores numéricos, o que explica por que rede neural é difícil de auditar caso a caso.
As famílias e o que cada uma resolve
| Família | Para que serve | Onde aparece |
|---|---|---|
| Convolucional | imagem e sinal com estrutura espacial | inspeção de defeito, leitura de documento, imagem médica |
| Recorrente | sequência, uma etapa por vez | série temporal e voz, hoje bastante substituída |
| Transformador | texto, e depois quase tudo, olhando a sequência inteira de uma vez | modelos de linguagem, tradução, código, também imagem e áudio |
| Difusão | gerar imagem e vídeo, partindo de ruído e refinando | geração de imagem a partir de texto |
A arquitetura transformadora é a que mudou o campo na última década, e é a base dos modelos de linguagem tratados em o que é um LLM. A capacidade de olhar a sequência inteira, em vez de palavra por palavra, é o que permitiu treinar em escala e o que deu origem à IA generativa.
O que o aprendizado profundo exige
- Volume de exemplo. Aprender as próprias características custa dado. Centenas de exemplos raramente bastam; milhares são o piso em problema simples.
- Rótulo, na maioria dos casos. Alguém precisa ter dito qual é a resposta certa, o que é trabalho humano e frequentemente o maior custo do projeto.
- Computação para treinar, normalmente com placa gráfica, alugada por hora ou embutida em serviço.
- Gente que saiba avaliar, porque rede neural mal avaliada erra com confiança, como mostram overfitting e underfitting.
Existe um atalho que mudou tudo para empresas: partir de um modelo já treinado em um conjunto enorme e adaptá-lo ao seu caso com poucos exemplos. É o que permite reconhecer um defeito específico da sua linha de produção com algumas centenas de fotos, em vez de milhões. O motivo é direto: as camadas iniciais, que aprenderam borda, textura e forma, servem para qualquer imagem, e só as últimas precisam aprender o que é específico do seu caso. Esse aproveitamento reduz de meses para semanas o prazo de um projeto de visão, e é o que separa projeto viável de exercício acadêmico.
Os termos que aparecem em toda conversa
Vale traduzir o vocabulário que aparece em proposta e em reunião técnica, porque ele esconde ideias simples:
- Época. Uma passagem completa de todos os exemplos pela rede. Treino tem muitas épocas, e o momento de parar é decidido pelo erro de validação.
- Parâmetro e peso. Os valores das conexões, que são o que o treino ajusta. Quando alguém diz que um modelo tem bilhões de parâmetros, está falando desses números.
- Camada oculta. Qualquer camada entre a entrada e a saída. Oculta não tem nada de misterioso: significa apenas que ela não é vista de fora.
- Função de ativação. A regra que decide se e quanto uma unidade repassa o sinal adiante. É o que permite à rede representar relação que não é linha reta.
- Taxa de aprendizado. O tamanho do passo de ajuste. Grande demais, o treino não converge; pequena demais, ele leva um tempo impraticável.
- Transferência de aprendizado. Aproveitar um modelo treinado em outro problema como ponto de partida, que é o atalho que viabiliza projeto de empresa.
Nada nessa lista precisa ser dominado por quem contrata. Serve para outra coisa: reconhecer quando o fornecedor está explicando e quando está usando jargão para não responder.
Quando não usar
- Dado em tabela. Para previsão sobre as tabelas que a empresa já tem, modelos mais simples de árvore continuam ganhando de rede neural, com menos custo e mais explicação.
- Pouco exemplo. Abaixo de alguns milhares de casos, o risco de decorar supera o ganho de flexibilidade.
- Necessidade de explicar caso a caso, como em crédito e cobrança com contestação. Modelo transparente e um pouco pior é melhor negócio.
- Regra clara já existente. Se a decisão cabe em uma regra escrita, escrever a regra é mais barato, mais rápido e auditável.
Onde uma empresa comum encontra isso
Quase nenhuma empresa treina uma rede do zero, e não precisa. O aprendizado profundo chega de três formas, em ordem de esforço:
- Serviço pronto por interface de programação. Reconhecimento de texto em imagem, transcrição de áudio, tradução, análise de documento. Paga-se por uso e funciona no mesmo dia.
- Modelo pré-treinado adaptado ao seu caso, com algumas centenas de exemplos rotulados. É o caminho de melhor relação entre custo e resultado quando o problema é específico da empresa.
- Modelo próprio treinado desde o início, que só se justifica com dado proprietário abundante e um problema que nenhum modelo existente resolve.
A decisão entre esses três caminhos é a mesma de qualquer projeto de IA, descrita em como criar uma inteligência artificial, com a conta em quanto custa criar uma IA. Para situar o aprendizado profundo entre as categorias da área, vale tipos de IA, e para a base, o que é inteligência artificial. Antes de qualquer construção, o recorte: como definir o escopo do primeiro produto digital.
Perguntas frequentes
O que é deep learning?
É aprendizado de máquina com muitas camadas, e a consequência que importa é esta: o modelo descobre sozinho quais características dos dados usar. No aprendizado de máquina clássico, alguém precisa dizer ao modelo o que olhar. No profundo, ele extrai isso das camadas, e é por isso que funciona bem em imagem, áudio e texto, onde ninguém sabe listar de antemão o que importa.
O que significa profundo em rede neural?
Significa apenas que existem muitas camadas entre a entrada e a saída. O ganho dessas camadas do meio é a construção progressiva de representação: em uma rede que reconhece imagem, as primeiras detectam borda e textura, as seguintes combinam isso em forma e as últimas em objeto. Ninguém programou o que é uma borda; a rede chegou nisso porque era a forma mais útil de organizar a informação.
Como uma rede neural aprende?
Em cinco passos que se repetem. Ela chuta, porque as conexões começam com valores aleatórios. Mede o erro contra a resposta certa. Distribui a culpa, calculando quanto cada conexão contribuiu para o erro, andando da saída de volta até a entrada. Ajusta cada conexão um pouco na direção que reduz o erro. E repete milhares de vezes. Daí saem duas consequências: treinar é caro, usar é barato, e o resultado é opaco.
Quais são os tipos de rede neural?
Quatro famílias cobrem o que se usa hoje. Convolucional, para imagem e sinal com estrutura espacial, presente em inspeção de defeito e leitura de documento. Recorrente, para sequência uma etapa por vez, hoje bastante substituída. Transformadora, que olha a sequência inteira de uma vez e é a base dos modelos de linguagem. E difusão, que gera imagem partindo de ruído e refinando.
Qual a diferença entre deep learning e machine learning?
Deep learning é uma parte do machine learning, não uma alternativa a ele. A diferença prática está em quem escolhe as características: no aprendizado de máquina clássico, uma pessoa define o que o modelo olha; no profundo, o modelo aprende isso das camadas. Isso amplia o alcance para dado não estruturado e aumenta a exigência de exemplos e de computação.
O que deep learning exige para funcionar?
Volume de exemplos, porque aprender as próprias características custa dado, e milhares são o piso em problema simples. Rótulo na maioria dos casos, o que é trabalho humano e frequentemente o maior custo. Computação para treinar, normalmente com placa gráfica. E gente que saiba avaliar, porque rede mal avaliada erra com confiança. Existe um atalho: partir de modelo já treinado e adaptá-lo com poucos exemplos.
O que é transferência de aprendizado?
É aproveitar um modelo treinado em um problema grande como ponto de partida para o seu. Funciona porque as camadas iniciais, que aprenderam borda, textura e forma, servem para qualquer imagem, e só as últimas precisam aprender o que é específico do seu caso. É o que permite reconhecer um defeito da sua linha de produção com algumas centenas de fotos, em vez de milhões, e reduz o prazo de meses para semanas.
Quando não usar deep learning?
Em dado de tabela, porque para previsão sobre as tabelas que a empresa já tem os modelos de árvore continuam ganhando, com menos custo e mais explicação. Com poucos exemplos, abaixo de alguns milhares de casos. Quando a decisão precisa ser explicada caso a caso, como crédito com contestação. E quando uma regra escrita resolve, porque aí ela é mais barata, mais rápida e auditável.
Preciso treinar minha própria rede neural?
Quase nunca. O aprendizado profundo chega às empresas de três formas, em ordem de esforço: serviço pronto por interface de programação, para reconhecer texto em imagem, transcrever áudio ou analisar documento, que funciona no mesmo dia; modelo pré-treinado adaptado com algumas centenas de exemplos, que é a melhor relação entre custo e resultado em problema específico; e modelo próprio desde o início, que só se justifica com dado proprietário abundante.
O que significam época, peso e taxa de aprendizado?
Época é uma passagem completa de todos os exemplos pela rede. Peso e parâmetro são os valores das conexões, que é o que o treino ajusta, e é a eles que se refere quem fala em bilhões de parâmetros. Taxa de aprendizado é o tamanho do passo de ajuste: grande demais, o treino não converge; pequena demais, ele leva um tempo impraticável. Reconhecer esses termos serve para perceber quando o fornecedor está explicando e quando está usando jargão para não responder.