“Criar uma IA com Python” descreve três trabalhos muito diferentes, com esforço e custo que variam em ordens de grandeza. Escolher qual deles você quer fazer é a decisão que economiza mais tempo, e é a que quase nenhum tutorial explica antes de mandar instalar biblioteca.
Este texto separa os três caminhos, mostra o setup mínimo, o primeiro projeto que realmente funciona, as bibliotecas que importam, onde todo iniciante trava e o que não é necessário.
Os três caminhos
| Caminho | O que você faz | Esforço |
|---|---|---|
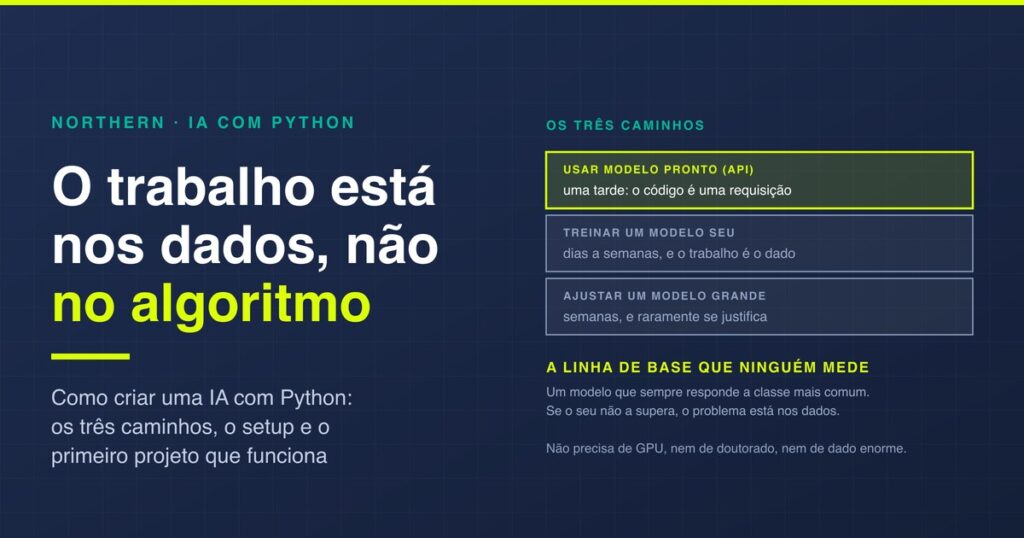
| Usar um modelo pronto | chamar por API um modelo que outra empresa treinou e mantém | uma tarde; o código é uma requisição HTTP |
| Treinar um modelo seu | ensinar um algoritmo a prever ou classificar a partir dos seus dados | dias a semanas; o trabalho está nos dados, não no algoritmo |
| Ajustar um modelo grande | especializar um modelo de linguagem com exemplos próprios | semanas, com custo de máquina e conhecimento específico |
Para quase todo projeto que aparece na prática, o primeiro caminho resolve. O segundo é o que ensina de verdade como aprendizado de máquina funciona. O terceiro só se justifica quando existe um conjunto grande de exemplos que ninguém mais tem, e a diferença entre os três é o assunto de modelos de inteligência artificial.
O setup mínimo
- Python 3.11 ou mais novo, instalado do site oficial ou pelo gerenciador de pacotes do sistema.
- Um ambiente virtual por projeto, com
python -m venv .venv. Pular isso é a origem da maior parte dos conflitos de versão que travam iniciante. - Um editor com suporte a Python, ou um caderno interativo como Jupyter, que é mais confortável para experimentar.
- Um arquivo de dependências, para que o projeto volte a funcionar no mês seguinte e em outra máquina.
Nada de placa de vídeo, nada de servidor. Para aprender e para a maior parte dos projetos reais, um notebook comum é suficiente.
O primeiro projeto que funciona
Um classificador simples com scikit-learn, que é a biblioteca certa para começar. A sequência é sempre a mesma, e vale para prever cancelamento de cliente, classificar mensagem de atendimento ou estimar prazo de entrega:
- Consiga uma tabela. Linhas são exemplos, colunas são características, e uma coluna é a resposta que você quer prever. Sem essa tabela, não há projeto.
- Separe treino e teste, tipicamente 80% e 20%. O modelo só pode ser avaliado em dados que ele nunca viu.
- Escolha um algoritmo simples primeiro, como regressão logística ou árvore de decisão. Modelo complicado sem base de comparação não diz se está bom.
- Treine, o que em scikit-learn é uma linha:
modelo.fit(X_treino, y_treino). - Meça no conjunto de teste, e olhe além da acurácia: acerto de 95% não vale nada quando 95% dos casos são de uma única classe.
- Compare com o burro. Um modelo que sempre responde a resposta mais comum é a linha de base. Se o seu não a supera, o problema está nos dados.
Repare que quatro dos seis passos são sobre dado e avaliação. Essa proporção não muda com o tempo: o que separa um modelo útil de um modelo bonito é quase sempre a qualidade do dado e a honestidade da medição, tema de machine learning: o que é de fato aprendizado de máquina.
Usar um modelo pronto por API
Se o objetivo é entender texto, gerar resumo, classificar mensagem ou responder pergunta, treinar do zero é o caminho mais longo e pior. O caminho curto é chamar um modelo de linguagem por API, e em Python isso são poucas linhas: instalar o cliente, guardar a chave em variável de ambiente e enviar a instrução com o texto.
- Nunca deixe a chave no código. Chave em repositório é o erro de segurança mais comum de projeto iniciante.
- Trate o custo como linha de projeto, porque é cobrado por volume de texto que entra e sai. A conta completa está em quanto custa criar uma IA.
- Valide a resposta. Modelo de linguagem devolve texto plausível, não texto verificado. Se a resposta precisa ser um número ou uma categoria, force um formato e confira.
- Dê fonte quando a pergunta é sobre a sua empresa, buscando no seu próprio material antes de perguntar ao modelo. Sem isso ele responde pelo que viu na internet, como explicado em IA generativa: como funciona e onde ela erra.
As bibliotecas que importam
- pandas para ler, limpar e transformar tabela. É onde você vai passar a maior parte do tempo, e não é desperdício: é o trabalho.
- scikit-learn para os modelos clássicos, divisão de dados, métricas e validação. Cobre a maior parte dos problemas de empresa.
- NumPy como base numérica, quase sempre usada por baixo das outras.
- matplotlib para olhar o dado antes de modelar. Gráfico simples revela erro que métrica esconde.
- PyTorch quando o problema exige rede neural de verdade, como imagem e áudio, assunto de o que é deep learning.
- Bibliotecas de texto quando o dado é linguagem, com o recorte explicado em processamento de linguagem natural.
Onde todo iniciante trava
- Instalação e versão. Resolve-se com ambiente virtual por projeto e um arquivo de dependências, sempre.
- Não ter dado. É o obstáculo real. Comece com um conjunto público para aprender o método, e só depois traga o dado da sua operação.
- Confundir acurácia com utilidade. Escolha a métrica pelo custo do erro: em detecção de fraude, deixar passar é muito mais caro que um falso alarme.
- Vazamento de informação, quando uma coluna carrega, sem que se perceba, a resposta que se quer prever. O modelo acerta tudo no teste e falha na vida real.
- Copiar código sem entender a etapa. Tutorial que funciona colado deixa de funcionar no primeiro dado diferente.
- Achar que o modelo termina o projeto. Modelo que não roda em nenhum lugar não resolve nada; ele precisa virar uma rotina que alguém usa.
O que você não precisa
- Placa de vídeo. Só faz diferença para treinar rede neural grande, e isso não é o seu primeiro projeto.
- Doutorado em matemática. Ajuda entender o que a métrica significa; escrever o algoritmo do zero não é necessário.
- Um conjunto de dados enorme. Alguns milhares de linhas bem etiquetadas rendem mais que milhões de linhas sujas.
- Treinar um modelo de linguagem próprio. Quase nunca se justifica; usar um pronto com bom material de contexto resolve melhor e mais barato.
- A biblioteca mais nova. Escolher pelo que tem documentação e comunidade poupa semanas.
Um caminho de estudo
- Python básico com pandas, até conseguir carregar uma tabela e responder perguntas sobre ela sem ajuda.
- Um problema de classificação do começo ao fim, com divisão de dados, métrica escolhida com critério e comparação com a linha de base.
- Um projeto usando modelo pronto por API, para sentir a diferença de esforço entre treinar e usar.
- Colocar algo em uso, mesmo que seja um script que roda toda segunda e manda um resumo por e-mail. É aqui que se aprende o que faltava.
- Só então rede neural, quando existir um problema que os modelos clássicos não resolvem.
Criar uma IA com Python é menos sobre inteligência artificial e mais sobre disciplina com dado: conseguir a tabela, medir com honestidade e colocar o resultado onde alguém use. A visão geral dos caminhos está em como criar uma inteligência artificial do zero, e as ferramentas que ajudam a escrever o código estão em IA para programar. Se a intenção é transformar isso em produto, o recorte vem antes do modelo: como definir o escopo do primeiro produto digital.
Perguntas frequentes
Como criar uma IA com Python?
Existem três caminhos com esforço muito diferente. Usar um modelo pronto por API, que leva uma tarde e cujo código é uma requisição HTTP. Treinar um modelo seu com os seus dados, o que leva dias ou semanas e em que o trabalho está nos dados, não no algoritmo. E ajustar um modelo de linguagem grande com exemplos próprios, o que leva semanas e raramente se justifica. Para a maior parte dos projetos, o primeiro resolve.
O que preciso instalar para começar?
Python 3.11 ou mais novo, um ambiente virtual por projeto criado com python -m venv .venv, um editor com suporte a Python ou um caderno Jupyter, e um arquivo de dependências para o projeto voltar a funcionar em outra máquina. Pular o ambiente virtual é a origem da maior parte dos conflitos de versão que travam iniciante. Não é preciso placa de vídeo nem servidor.
Qual é o primeiro projeto de IA em Python que funciona?
Um classificador com scikit-learn. A sequência é: conseguir uma tabela em que linhas são exemplos e uma coluna é a resposta a prever; separar treino e teste, tipicamente 80% e 20%; escolher um algoritmo simples primeiro, como regressão logística ou árvore de decisão; treinar; medir no conjunto de teste olhando além da acurácia; e comparar com a linha de base, que é um modelo que sempre responde a classe mais comum.
Quais bibliotecas Python usar para IA?
pandas para ler, limpar e transformar tabela, que é onde você passa a maior parte do tempo. scikit-learn para os modelos clássicos, divisão de dados e métricas, o que cobre a maior parte dos problemas de empresa. NumPy como base numérica. matplotlib para olhar o dado antes de modelar. PyTorch quando o problema exige rede neural, como imagem e áudio. E bibliotecas de texto quando o dado é linguagem.
Preciso de placa de vídeo para criar uma IA?
Não. GPU só faz diferença para treinar rede neural grande, e isso não é um primeiro projeto. Para aprender e para a maior parte dos projetos reais de empresa, um notebook comum resolve. Também não é necessário doutorado em matemática, nem um conjunto de dados enorme: alguns milhares de linhas bem etiquetadas rendem mais que milhões de linhas sujas.
É melhor treinar um modelo ou usar um pronto por API?
Se o objetivo envolve texto, como entender, resumir, classificar ou responder, usar um modelo pronto por API é mais curto e melhor. Treinar faz sentido quando o problema é de previsão sobre dados próprios, como prever cancelamento ou estimar prazo, e quando existe histórico para isso. Treinar um modelo de linguagem do zero quase nunca se justifica.
Que cuidados ter ao usar IA por API em Python?
Nunca deixar a chave no código, porque chave em repositório é o erro de segurança mais comum de projeto iniciante: ela vai em variável de ambiente. Tratar o custo como linha de projeto, já que é cobrado por volume de texto. Validar a resposta, porque modelo de linguagem devolve texto plausível e não verificado. E dar fonte quando a pergunta é sobre a sua empresa, buscando no próprio material antes de perguntar ao modelo.
Por que meu modelo acerta no teste e falha na prática?
A causa mais comum é vazamento de informação: alguma coluna carrega, sem que se perceba, a resposta que se quer prever, e o modelo aprende o atalho. A segunda é a métrica escolhida sem critério, já que acerto de 95% não vale nada quando 95% dos casos são de uma única classe. E a terceira é o conjunto de teste não representar os dados reais de uso.
Como escolher a métrica certa do modelo?
Pelo custo do erro, não pela métrica mais citada. Em detecção de fraude, deixar passar um caso é muito mais caro que um falso alarme, então o que importa é a fração de casos reais capturados. Em triagem que gera trabalho humano, o custo está no falso alarme. A acurácia só é informativa quando as classes estão equilibradas, e é justamente aí que quase nenhum problema real se encaixa.
Qual caminho de estudo seguir?
Python básico com pandas até conseguir carregar uma tabela e responder perguntas sobre ela sem ajuda. Um problema de classificação do começo ao fim, com métrica escolhida com critério e comparação com a linha de base. Um projeto usando modelo pronto por API, para sentir a diferença de esforço. Colocar algo em uso, mesmo que seja um script semanal. E só então rede neural, quando os modelos clássicos não resolverem.