Inteligência artificial é o campo que constrói sistemas capazes de executar tarefas que, feitas por pessoas, exigiriam inteligência: reconhecer imagens, entender texto, prever resultados, decidir entre opções. O termo existe desde 1956, mas o que mudou nos últimos anos não foi a definição, e sim o que essas máquinas passaram a conseguir fazer.
A confusão que atrapalha quase toda conversa sobre o assunto vem de tratar IA, aprendizado de máquina e IA generativa como sinônimos. São coisas encaixadas umas dentro das outras, e desembaralhar isso é o começo deste guia.
IA, machine learning, deep learning e generativa
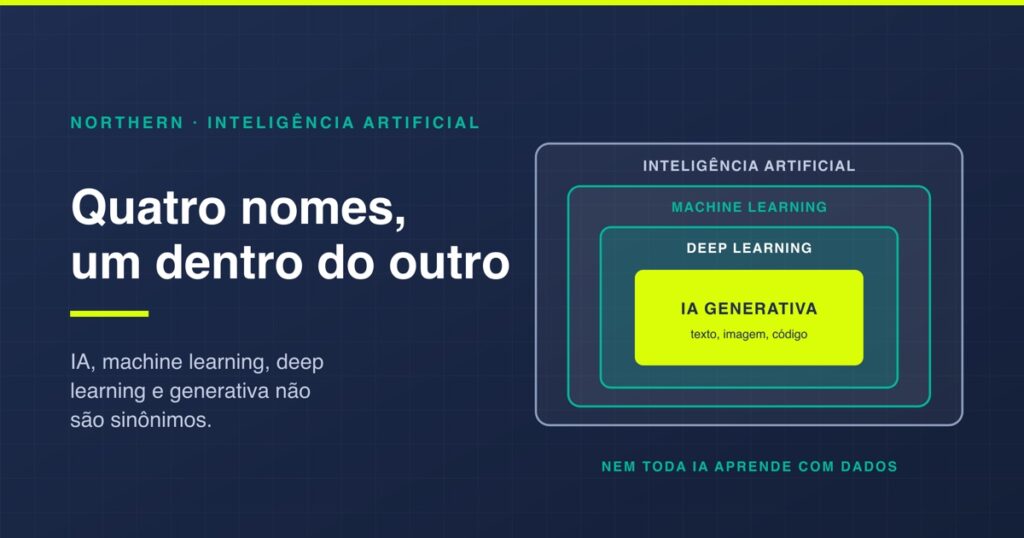
São quatro círculos, cada um dentro do anterior:
| Termo | O que é | Exemplo |
|---|---|---|
| Inteligência artificial | O campo inteiro, incluindo sistemas baseados em regras escritas por pessoas | Um sistema antifraude com regras fixas |
| Machine learning | Sistemas que aprendem padrões a partir de dados, em vez de seguir regras escritas | Previsão de cancelamento de clientes |
| Deep learning | Machine learning com redes neurais de muitas camadas | Reconhecimento de imagem |
| IA generativa | Deep learning aplicado a produzir conteúdo novo | Texto, imagem e código gerados sob demanda |
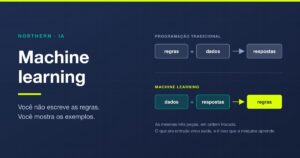
A distinção mais útil é a segunda linha. Em um sistema tradicional, alguém escreve a regra: “se o valor for acima de X e o país for Y, bloqueie”. Em machine learning, ninguém escreve a regra: o sistema recebe milhares de casos rotulados como fraude ou não fraude e deduz sozinho quais combinações indicam risco. Isso resolve problemas que ninguém consegue descrever em regras, e cria um problema novo, que é explicar por que a máquina decidiu o que decidiu.
Os detalhes de cada camada estão em machine learning: o que é e tipos de aprendizado e o que é deep learning.
Vale registrar que nem toda IA é machine learning. Sistemas baseados em regras escritas por especialistas continuam em operação em muitos lugares e resolvem bem problemas em que as regras são conhecidas, estáveis e precisam ser auditáveis. Quando alguém diz que uma empresa “usa IA”, a pergunta seguinte deveria ser qual dessas camadas está em jogo, porque as exigências de dados, custo e explicabilidade mudam completamente entre elas.
Como uma IA aprende
Treinar um modelo é ajustar seus parâmetros até que ele acerte com frequência aceitável em dados que nunca viu. Três formas dominam:
- Aprendizado supervisionado. O modelo recebe exemplos com a resposta certa: mil e-mails marcados como spam ou não spam. É o mais comum em aplicação empresarial, e o mais caro, porque alguém precisa rotular os exemplos.
- Aprendizado não supervisionado. O modelo recebe dados sem resposta e procura estrutura por conta própria, agrupando clientes com comportamento parecido, por exemplo. Útil quando não se sabe o que procurar.
- Aprendizado por reforço. O modelo tenta, recebe recompensa ou punição e ajusta a estratégia. É o mecanismo por trás de sistemas que aprendem a jogar e de parte do refinamento dos modelos de linguagem.
Duas armadilhas aparecem sempre nesse processo. O modelo pode decorar os exemplos de treino em vez de aprender o padrão, indo bem no teste e mal na vida real, o que se chama overfitting. Ou pode ser simples demais para capturar o padrão, errando em tudo, o que é underfitting. Boa parte do trabalho de quem constrói esses sistemas é encontrar o ponto entre os dois.
Há ainda uma etapa que costuma ser subestimada e consome a maior parte do tempo de um projeto real: preparar os dados. Reunir o histórico, corrigir inconsistências, tratar registros faltantes, padronizar formatos e decidir quais informações entram como entrada do modelo. Equipes experientes estimam que essa preparação toma a maior fatia do esforço, e é a etapa que não aparece em nenhuma demonstração de produto.
O que mudou com os modelos de linguagem
A virada recente tem uma origem identificável: uma arquitetura de rede neural publicada em 2017, chamada transformer, que processa uma sequência inteira de texto de uma vez em vez de palavra por palavra, e aprende quais partes do texto se relacionam com quais.
Sobre ela foram construídos os modelos de linguagem de grande porte. O treinamento é conceitualmente simples e desconcertante: o modelo é exposto a uma quantidade enorme de texto e treinado para prever a próxima palavra. Repetido em escala suficiente, esse exercício produz sistemas capazes de resumir, traduzir, responder, programar e redigir.
Isso explica dois comportamentos que confundem quem usa. Primeiro, o modelo não consulta uma base de fatos: ele produz a continuação mais provável, o que é diferente de produzir a continuação verdadeira. Segundo, ele não tem noção do que sabe ou não sabe, e por isso responde com a mesma segurança quando acerta e quando inventa. O percurso técnico está em processamento de linguagem natural, e a linha do tempo em a evolução da inteligência artificial, de Deep Blue aos LLMs.
Uma consequência prática dessa mecânica é que a qualidade da resposta depende fortemente de como o pedido é formulado. Não porque exista uma fórmula mágica de instrução, mas porque o modelo continua o texto que recebe: um pedido vago produz uma continuação vaga, e um pedido que traz contexto, formato esperado e restrições produz uma continuação melhor ajustada. Isso também explica por que a mesma pergunta pode gerar respostas diferentes a cada vez, já que há aleatoriedade deliberada na escolha das palavras.
Generativa e preditiva resolvem problemas diferentes
A atenção dos últimos anos foi toda para a IA generativa, e isso levou muitas empresas a procurar problemas para uma solução em vez do contrário. As duas famílias servem a coisas distintas:
| IA preditiva | IA generativa | |
|---|---|---|
| Responde | O que vai acontecer, ou a que categoria isto pertence | Produza algo novo a partir disto |
| Saída | Um número, uma classe, uma probabilidade | Texto, imagem, áudio, código |
| Avaliação | Objetiva: acertou ou errou | Subjetiva: serve ou não serve |
| Casos | Risco de crédito, previsão de demanda, detecção de fraude | Atendimento, redação, apoio à programação, resumo |
A diferença na linha de avaliação é a que mais custa em projeto. Um modelo preditivo tem acurácia mensurável antes de entrar em produção. Um modelo generativo precisa de julgamento humano para dizer se a saída presta, e montar esse processo de avaliação é parte do trabalho, não um detalhe posterior. Mais sobre essa família em IA generativa: o que é e como funciona.
IA estreita e IA geral: onde estamos
Toda inteligência artificial em funcionamento hoje é estreita: resolve uma tarefa ou um conjunto limitado de tarefas relacionadas. Um modelo que joga xadrez em nível sobre-humano não sabe atravessar a rua. Um modelo de linguagem que escreve e programa não dirige um carro. A competência é impressionante dentro do domínio e inexistente fora dele.
O que se chama de IA geral seria um sistema capaz de aprender e executar qualquer tarefa intelectual que uma pessoa executa, transferindo aprendizado entre domínios. Isso não existe, e não há consenso sobre quando ou se existirá. Os modelos recentes tornaram a fronteira mais confusa, porque um único modelo de linguagem realiza tarefas muito variadas, mas ele continua operando por padrões aprendidos em texto, e não por compreensão transferível do mundo.
A distinção importa para decisões de negócio por um motivo prático: discussões sobre IA geral não deveriam influenciar projetos de IA estreita, que é o que se contrata e se constrói. As classificações completas, incluindo os quatro tipos usados na literatura, estão em tipos de IA: classificações e o que cada uma faz.
Onde a IA já é usada de verdade
Separando aplicação corrente de promessa, é isto que já opera em escala:
- Recomendação e personalização. O uso mais antigo e mais lucrativo, presente em comércio eletrônico, streaming e redes sociais. Funciona porque o retorno é medido diretamente em conversão.
- Detecção de fraude e risco de crédito. Instituições financeiras usam modelos há décadas, muito antes de o assunto virar tema público.
- Visão computacional. Leitura de documentos, inspeção de qualidade em produção, análise de imagem médica como apoio ao diagnóstico.
- Atendimento e suporte. Onde os modelos de linguagem tiveram adoção mais rápida, resolvendo perguntas repetitivas e encaminhando o resto.
- Apoio à programação. Sugestão e revisão de código, hoje incorporadas ao trabalho diário de quem desenvolve.
- Previsão de demanda e logística. Estoque, rota e capacidade, onde uma melhora pequena na previsão vira economia grande.
Repare no que essas aplicações têm em comum: todas envolvem um volume de decisões repetitivas grande o bastante para que um ganho percentual pequeno se torne relevante. É esse o formato de problema em que a tecnologia se paga.
Vale acrescentar que as duas famílias se combinam com frequência em aplicações reais. Um sistema de atendimento pode usar um modelo preditivo para classificar a urgência do chamado e um modelo generativo para redigir a resposta; um sistema de crédito pode calcular o risco com um modelo estatístico e usar linguagem para explicar a decisão ao cliente. Tratar as duas como concorrentes é um erro de enquadramento: elas ocupam etapas diferentes do mesmo fluxo.
O que a IA não faz
Esta seção evita mais prejuízo que qualquer outra:
- Não entende no sentido humano. Reconhece e reproduz padrões estatísticos com competência impressionante, o que não é a mesma coisa que compreender significado, intenção ou consequência.
- Não distingue verdadeiro de plausível. Modelos generativos produzem informação incorreta com a mesma fluência com que produzem a correta, incluindo referências, números e citações que não existem. Toda saída usada em decisão precisa de verificação.
- Não corrige dados ruins. Um modelo treinado com histórico enviesado reproduz o viés com aparência de objetividade matemática. A máquina não neutraliza o problema, ela o escala.
- Não sabe o que aconteceu depois do treino. Salvo quando conectado a uma fonte externa de dados, o modelo desconhece qualquer evento posterior aos dados com que foi treinado.
- Não explica a própria decisão. Em modelos complexos, saber por que aquele resultado saiu é um problema técnico em aberto, e isso pesa onde a decisão precisa ser justificada, como crédito e seleção.
Há um limite adicional que é de natureza diferente dos anteriores: a IA não assume responsabilidade. Ela produz uma saída, e alguém precisa decidir se aquilo será usado. Sistemas colocados em produção sem essa figura definida, o responsável por revisar e por responder pelo resultado, acabam gerando decisões que ninguém consegue explicar nem defender depois. Definir esse papel é parte do projeto, e não uma formalidade posterior.
Como uma empresa começa
A ordem que funciona é o inverso da que costuma ser tentada. Em vez de escolher a tecnologia e procurar onde aplicar:
- Escolha uma decisão repetitiva e cara. Algo que acontece centenas de vezes por mês e em que errar custa dinheiro. É aí que a conta fecha.
- Confira se os dados existem. Não a promessa de dados: o histórico real, acessível e com qualidade suficiente. É aqui que a maior parte dos projetos descobre que não pode continuar.
- Defina o que é sucesso antes de começar. Qual número precisa melhorar e quanto. Sem isso, o projeto termina em demonstração que impressiona e não é adotada.
- Comece contratando antes de construir. Boa parte dos casos comuns já existe como produto pronto. Construir do zero só se justifica quando o problema é específico da empresa.
- Planeje a operação. Modelo em produção precisa de monitoramento, porque o desempenho cai conforme a realidade muda, e de alguém responsável por revisar o que ele decide.
O critério que separa o que vale construir do que vale contratar é o mesmo de qualquer software: três critérios que dizem se uma ferramenta interna vira produto.
Um erro de sequência merece destaque à parte, porque é o mais caro e o mais comum: começar pela ferramenta. Uma empresa decide adotar IA, escolhe uma plataforma, monta um piloto e só então procura em que aplicar. O resultado típico é uma prova de conceito bem-sucedida tecnicamente que nunca entra em operação, porque não estava resolvendo um problema que alguém queria resolver. A pergunta inicial não é qual IA usar, é qual decisão da empresa é repetitiva, cara e baseada em informação que já existe.
Viés, privacidade e regulação
Três frentes concentram os riscos, e nenhuma é resolvida pela tecnologia sozinha.
Viés. Modelos aprendem dos dados que recebem, e dados históricos carregam as desigualdades do período em que foram gerados. Um modelo de seleção treinado com contratações passadas reproduz os critérios que foram usados, inclusive os que ninguém assumiria por escrito. A responsabilidade é de quem escolhe os dados e valida o resultado, não do algoritmo.
Privacidade. Dado pessoal usado em treinamento continua sendo dado pessoal, e a LGPD se aplica: é preciso base legal para o tratamento, e o titular mantém seus direitos. Enviar informação de cliente para um serviço externo de IA é uma transferência de dados, com todas as obrigações que isso implica.
Regulação. A União Europeia aprovou um marco regulatório próprio para IA, e no Brasil há projeto de lei em tramitação para regular o tema, com abordagem baseada em nível de risco. Como o texto ainda pode mudar, convém confirmar o estágio atual em fonte oficial antes de decisões de conformidade, mas a direção é clara: aplicações de alto risco terão exigências específicas de transparência e supervisão humana.
Uma quarta frente merece atenção de quem contrata: a responsabilidade não é transferível. Se um sistema automatizado nega um crédito, recusa uma candidatura ou envia uma informação errada a um cliente, quem responde é a empresa que o colocou em operação, não o fornecedor do modelo. Isso torna a supervisão humana em decisões sensíveis menos uma boa prática e mais uma proteção contratual e jurídica.
Por fim, um ponto de método que atravessa as três frentes: risco de IA não se avalia olhando o modelo, e sim a decisão que ele influencia. O mesmo algoritmo de classificação é irrelevante quando organiza fotos e é sensível quando ordena candidatos a uma vaga ou prioriza atendimentos em uma fila de saúde. O que define o nível de cuidado necessário é o impacto sobre quem está do outro lado, e não a sofisticação técnica de quem construiu.
O que muda daqui para a frente
Sem previsão de ficção científica, três movimentos já estão em curso e são razoavelmente seguros de apontar.
O primeiro é o barateamento. O custo de usar modelos capazes cai de forma consistente, o que muda o cálculo de viabilidade de aplicações que hoje não se pagam.
O segundo é a especialização. Modelos menores, treinados ou ajustados para domínios específicos, tendem a superar modelos gerais em tarefas restritas, com custo e requisito de infraestrutura muito menores.
O terceiro é a integração. A IA está deixando de ser um produto separado, com sua própria interface, para virar uma camada dentro de ferramentas que já existem. Para a maioria das empresas, isso significa que a adoção vai acontecer menos por projeto e mais por atualização de software que já se usa.
O que não muda é o que decide o resultado: dados disponíveis, um problema que valha a pena resolver e alguém responsável por conferir o que a máquina entrega. Os tipos e classificações de IA estão em tipos de IA: classificações e o que cada uma faz, e o corte de escopo que antecede qualquer projeto em como definir o escopo do primeiro produto digital.
Perguntas frequentes
O que é inteligência artificial?
É o campo que constrói sistemas capazes de executar tarefas que, feitas por pessoas, exigiriam inteligência: reconhecer imagens, entender texto, prever resultados, decidir entre opções. O termo existe desde 1956, e o que mudou nos últimos anos não foi a definição, e sim o que essas máquinas passaram a conseguir fazer.
Qual a diferença entre IA, machine learning, deep learning e IA generativa?
São quatro círculos, cada um dentro do anterior. Inteligência artificial é o campo inteiro, incluindo sistemas baseados em regras escritas por pessoas. Machine learning é a parte em que o sistema aprende padrões a partir de dados, em vez de seguir regras escritas. Deep learning é machine learning com redes neurais de muitas camadas. E IA generativa é deep learning aplicado a produzir conteúdo novo, como texto, imagem e código.
Como uma inteligência artificial aprende?
De três formas principais. No aprendizado supervisionado, o modelo recebe exemplos com a resposta certa, como mil e-mails marcados como spam ou não spam; é o mais comum em empresas e o mais caro, porque alguém precisa rotular. No não supervisionado, recebe dados sem resposta e procura estrutura sozinho, agrupando casos parecidos. No aprendizado por reforço, tenta, recebe recompensa ou punição e ajusta a estratégia.
Por que a IA às vezes inventa informação?
Porque um modelo de linguagem não consulta uma base de fatos: ele foi treinado para prever a próxima palavra, e produz a continuação mais provável, o que é diferente de produzir a continuação verdadeira. Ele também não tem noção do que sabe ou não sabe, e por isso responde com a mesma segurança quando acerta e quando inventa, inclusive referências, números e citações inexistentes. Toda saída usada em decisão precisa de verificação.
Qual a diferença entre IA preditiva e IA generativa?
A preditiva responde o que vai acontecer ou a que categoria algo pertence, devolvendo um número, uma classe ou uma probabilidade, e sua avaliação é objetiva: acertou ou errou. A generativa produz algo novo, como texto, imagem ou código, e sua avaliação é subjetiva: serve ou não serve. Essa diferença é a que mais custa em projeto, porque um modelo generativo exige montar um processo de julgamento humano antes de entrar em operação.
Já existe inteligência artificial geral?
Não. Toda IA em funcionamento hoje é estreita: resolve uma tarefa ou um conjunto limitado de tarefas relacionadas, com competência impressionante dentro do domínio e inexistente fora dele. IA geral seria um sistema capaz de aprender e executar qualquer tarefa intelectual humana, transferindo aprendizado entre domínios, e não há consenso sobre quando ou se existirá. Discussões sobre IA geral não deveriam influenciar projetos de IA estreita, que é o que se contrata e se constrói.
O que a inteligência artificial não faz?
Não entende no sentido humano, apenas reconhece e reproduz padrões estatísticos. Não distingue verdadeiro de plausível. Não corrige dados ruins: um modelo treinado com histórico enviesado reproduz o viés com aparência de objetividade matemática, escalando o problema em vez de neutralizá-lo. Não sabe o que aconteceu depois do treino, salvo se conectado a uma fonte externa. Não explica a própria decisão em modelos complexos. E não assume responsabilidade.
Como uma empresa deve começar a usar IA?
Pela decisão, não pela ferramenta. Escolha uma decisão repetitiva e cara, que aconteça centenas de vezes por mês. Confira se os dados existem de fato, com qualidade e acesso, porque é aqui que a maioria dos projetos descobre que não pode continuar. Defina o que é sucesso antes de começar. Comece contratando produto pronto antes de construir. E planeje a operação, com monitoramento e um responsável por revisar o que o modelo decide.
Qual o erro mais comum em projetos de IA?
Começar pela ferramenta. A empresa decide adotar IA, escolhe uma plataforma, monta um piloto e só então procura em que aplicar. O resultado típico é uma prova de conceito tecnicamente bem-sucedida que nunca entra em operação, porque não resolvia um problema que alguém queria resolver. A pergunta inicial não é qual IA usar, e sim qual decisão da empresa é repetitiva, cara e baseada em informação que já existe.
Quais são os riscos legais de usar IA no Brasil?
Três frentes. Viés, já que modelos reproduzem as desigualdades presentes nos dados históricos, e a responsabilidade é de quem escolhe os dados e valida o resultado. Privacidade, porque dado pessoal usado em treinamento continua sujeito à LGPD, e enviar informação de cliente a um serviço externo de IA é uma transferência de dados. E regulação: a União Europeia aprovou seu marco e no Brasil há projeto de lei em tramitação, com abordagem baseada em nível de risco, cujo estágio atual convém confirmar em fonte oficial.