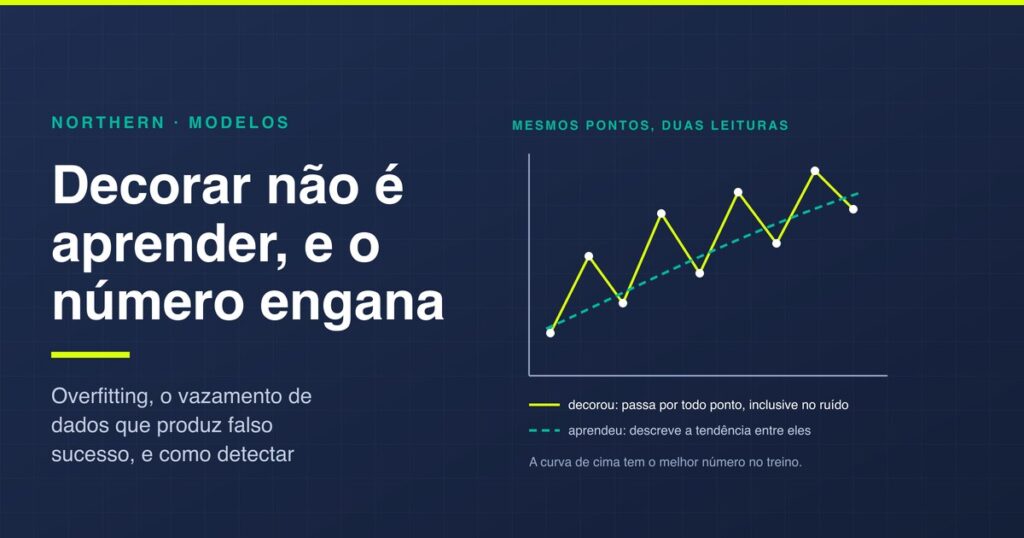
Overfitting é quando o modelo decora em vez de aprender: ele acerta quase tudo no material que viu e erra no que nunca viu. A imagem clássica é uma curva que passa exatamente por todos os pontos do gráfico, inclusive pelos que são ruído, em vez de descrever a tendência que existe entre eles.
O que torna esse erro perigoso não é a dificuldade técnica, é a aparência: um modelo sobreajustado se apresenta com números excelentes. Este texto trata de como ele nasce, do vazamento de dados que produz os casos mais espetaculares de falso sucesso, de como detectar e de como evitar.
Como o overfitting nasce
A causa raiz é sempre a mesma: o modelo tem capacidade de sobra em relação à quantidade de informação real disponível. Isso aparece de três formas:
- Modelo grande demais para o problema. Muitas variáveis, muitos parâmetros, muita liberdade. Com espaço suficiente, o modelo encontra padrão em qualquer coisa, inclusive em coincidência.
- Dado pouco demais. Trinta exemplos e vinte variáveis é receita pronta: existe mais espaço de ajuste que evidência para sustentar o ajuste.
- Ajuste repetido no mesmo conjunto. Cada vez que alguém muda um parâmetro e testa no mesmo teste, aquele teste vira, aos poucos, parte do treino.
Existe uma forma mais sutil, e ela é frequente em projeto de empresa: variável que carrega informação demais sobre o resultado. Prever inadimplência usando um campo que só é preenchido depois da cobrança não é previsão, é leitura do gabarito.
Vazamento de dados: o caso mais traiçoeiro
Vazamento é quando informação que não estaria disponível no momento da decisão entra no treino. O modelo aprende com ela, acerta espetacularmente no teste e fracassa completamente em produção. É a causa dos números bonitos demais para serem verdade, e é o problema mais comum em projeto real.
As formas mais frequentes:
- Dado do futuro. Usar informação registrada depois do evento que se quer prever. Data de cancelamento para prever cancelamento, valor pago para prever pagamento, status final para prever o status.
- Separação aleatória em problema temporal. Embaralhar linhas de um histórico e tirar o teste do meio dele faz o modelo treinar com o futuro e ser avaliado no passado. Em previsão que envolve tempo, o teste tem que ser o período seguinte.
- Duplicatas entre treino e teste. O mesmo cliente, a mesma nota, o mesmo documento aparecendo nos dois lados. O modelo reconhece o registro em vez de generalizar.
- Preparação feita antes da separação. Calcular média, escala ou seleção de variável usando a base inteira contamina o teste com informação do conjunto todo.
- Identificador como variável. Código de cliente ou número sequencial que, sem querer, codifica a resposta, como um intervalo de código que corresponde a uma safra específica.
A defesa prática é uma pergunta feita variável por variável: essa informação estaria disponível, com esse valor, no momento em que a decisão precisa ser tomada? Se a resposta for não ou “depende”, ela sai.
Como detectar
- Compare o erro no treino e no teste. Erro baixo no treino e alto no teste é a assinatura, como está na matriz de underfitting e overfitting.
- Olhe a evolução do treino. Quando o erro de treino continua caindo e o de validação começa a subir, o ponto em que as curvas se separam é onde o modelo passou a decorar.
- Use validação cruzada. Treinar e avaliar em várias divisões diferentes revela se o desempenho depende de sorte na separação.
- Guarde um conjunto que ninguém toca. Um terceiro conjunto, usado uma única vez no fim, é o único número em que se pode confiar depois de muitas rodadas de ajuste.
- Desconfie do resultado bom demais. Acurácia muito acima do esperado para o problema é sinal de vazamento, não de talento.
Como evitar
- Mais dado, quando possível. É a solução mais eficaz e a menos disponível.
- Menos variável. Cortar o que não tem justificativa de negócio reduz o espaço em que o modelo pode se perder.
- Regularização. Penalizar complexidade no próprio treino, o que empurra o modelo para soluções mais simples.
- Parada antecipada. Interromper o treino no ponto em que a validação para de melhorar.
- Modelo mais simples primeiro. Começar pelo mais simples e subir de complexidade só quando o ganho aparecer nos dois conjuntos.
- Combinar modelos. Conjuntos de modelos mais simples costumam generalizar melhor que um modelo grande ajustado ao limite.
Overfitting existe em IA generativa?
Existe, com outra cara. Em modelo de linguagem, o equivalente aparece em três situações que interessam a quem usa:
- Memorização de trecho de treino. O modelo reproduz literalmente um texto que viu, o que gera problema de direito autoral e de privacidade quando o material era sensível.
- Ajuste fino em poucos exemplos. Especializar um modelo com trinta exemplos de resposta produz um sistema que imita aqueles trinta e piora em tudo o mais. É a razão pela qual ajuste fino serve para formato, não para conhecimento.
- Avaliação contaminada. Quando o teste usado para comparar modelos já circulou na internet, o resultado mede memorização, não capacidade. É um problema conhecido dos comparativos públicos, e é o motivo de medir com o seu próprio material.
A defesa é a mesma de sempre, adaptada: teste com casos que o modelo não pode ter visto, de preferência escritos por quem conhece a operação, como está em o que é um LLM.
O overfitting de quem constrói
Existe uma versão do problema que não está no algoritmo e sim no processo: o analista que testa cinquenta configurações no mesmo conjunto de validação e escolhe a melhor. O modelo escolhido é o que se ajustou melhor àquele conjunto específico, e parte do ganho é coincidência.
É por isso que projeto sério separa três conjuntos: treino, para aprender; validação, para escolher; e teste, tocado uma única vez, para reportar. Quem relata o número da validação como se fosse desempenho real está entregando um resultado otimista, quase sempre sem má intenção.
O que acontece em produção
Modelo sobreajustado tem um comportamento característico depois de entrar no ar: ele começa bem e piora rápido, porque estava colado a detalhes do período de treino. Modelo bem ajustado piora devagar, e a piora acompanha mudanças reais do negócio.
Três práticas evitam a surpresa:
- Acompanhar o erro em produção, comparando previsão com o que aconteceu de fato, mês a mês.
- Comparar sempre com a linha de base, que é o método que a empresa usava antes. Modelo que deixa de ganhar dela precisa ser revisto ou desligado.
- Definir gatilho de retreino, por tempo ou por queda de desempenho, decidido antes de o projeto entrar em operação.
Do lado de quem contrata, o resumo é curto: pedir sempre dois números, perguntar como os dados foram separados e desconfiar de acurácia alta demais. Essas três perguntas aparecem em quanto custa criar uma IA e em análise preditiva, e é onde a maior parte dos projetos se decide. Para o mapa das categorias, vale tipos de IA e o que é inteligência artificial. Se o projeto ainda está sendo desenhado, o recorte vem antes de qualquer modelo: como definir o escopo do primeiro produto digital.
Perguntas frequentes
O que é overfitting?
É quando o modelo decora em vez de aprender: acerta quase tudo no material que viu e erra no que nunca viu. A imagem clássica é uma curva que passa exatamente por todos os pontos do gráfico, inclusive pelos que são ruído, em vez de descrever a tendência entre eles. O que o torna perigoso não é a dificuldade técnica, é a aparência: um modelo sobreajustado se apresenta com números excelentes.
Por que o overfitting acontece?
Porque o modelo tem capacidade de sobra em relação à informação real disponível. Isso aparece de três formas: modelo grande demais para o problema, com liberdade para achar padrão em coincidência; dado pouco demais, como trinta exemplos e vinte variáveis; e ajuste repetido no mesmo conjunto de teste, que aos poucos transforma aquele teste em parte do treino.
O que é vazamento de dados?
É quando informação que não estaria disponível no momento da decisão entra no treino. O modelo aprende com ela, acerta espetacularmente no teste e fracassa em produção. É a causa dos números bonitos demais para serem verdade. As formas mais comuns são dado do futuro, separação aleatória em problema temporal, duplicatas entre treino e teste, preparação feita antes da separação e identificador que codifica a resposta sem ninguém perceber.
Como evitar vazamento de dados?
Com uma pergunta feita variável por variável: essa informação estaria disponível, com esse valor, no momento em que a decisão precisa ser tomada? Se a resposta for não, ou depende, a variável sai. Em problema que envolve tempo, o teste precisa ser o período seguinte, nunca uma amostra aleatória do mesmo período, e toda preparação de dado deve ser calculada depois da separação, não antes.
Como detectar overfitting?
Comparando o erro no treino com o erro no teste: baixo no treino e alto no teste é a assinatura. Vale também olhar a evolução do treino, porque o ponto em que o erro de validação começa a subir enquanto o de treino continua caindo é onde o modelo passou a decorar. Validação cruzada revela dependência de sorte na separação, e um terceiro conjunto tocado uma única vez é o único número confiável depois de muitas rodadas de ajuste.
Como evitar overfitting?
Mais dado, quando possível, que é a solução mais eficaz e a menos disponível. Menos variável, cortando o que não tem justificativa de negócio. Regularização, que penaliza complexidade durante o treino. Parada antecipada, interrompendo quando a validação para de melhorar. Começar pelo modelo mais simples e subir de complexidade só quando o ganho aparecer nos dois conjuntos. E combinar modelos simples, que costuma generalizar melhor que um modelo grande ajustado ao limite.
Existe overfitting em IA generativa?
Existe, com outra cara. Aparece como memorização de trecho de treino, quando o modelo reproduz literalmente um texto que viu, com problema de direito autoral e de privacidade. Aparece em ajuste fino com poucos exemplos, que produz um sistema que imita aqueles exemplos e piora em todo o resto. E aparece em avaliação contaminada, quando o teste usado para comparar modelos já circulou na internet e passa a medir memorização em vez de capacidade.
O que é overfitting do analista?
É a versão do problema que está no processo, e não no algoritmo: alguém testa cinquenta configurações no mesmo conjunto de validação e escolhe a melhor. O modelo escolhido é o que se ajustou àquele conjunto específico, e parte do ganho é coincidência. É por isso que projeto sério separa três conjuntos: treino para aprender, validação para escolher e teste tocado uma única vez para reportar.
Como o overfitting se manifesta em produção?
Com um comportamento característico: o modelo começa bem e piora rápido, porque estava colado a detalhes do período de treino. Modelo bem ajustado piora devagar, e a piora acompanha mudanças reais do negócio. Três práticas evitam a surpresa: acompanhar o erro real mês a mês, comparar sempre com a linha de base que a empresa usava antes, e definir o gatilho de retreino antes de entrar em operação.
O que perguntar ao fornecedor para se proteger?
Três coisas. Peça sempre dois números, o erro no treino e o erro no teste, porque um número só não diz nada. Pergunte como os dados foram separados, com atenção especial a problemas que envolvem tempo. E desconfie de acurácia alta demais para o problema: resultado muito acima do esperado costuma ser sinal de vazamento, não de talento.