Insurtech é o uso de tecnologia para mudar como o seguro é vendido, precificado e pago. O termo nasceu com as startups do setor, mas hoje descreve principalmente o que as seguradoras tradicionais estão fazendo por dentro, e a maior parte disso passa por modelos que aprendem com dados.
Este texto mostra onde a inteligência artificial já opera de fato numa seguradora, onde ela ainda depende de gente, e o que a lei brasileira exige de quem automatiza decisões que afetam a vida de uma pessoa.
O que é insurtech
Insurtech é a contração de insurance com technology, no mesmo molde de fintech. Designa tanto as empresas nascidas digitais que vendem seguro quanto a transformação tecnológica dentro das seguradoras já estabelecidas.
Vale desfazer uma confusão comum: insurtech não é sinônimo de seguradora digital. Boa parte das insurtechs brasileiras não emite apólice própria: são corretoras digitais, plataformas de distribuição, ou fornecedores de tecnologia que vendem para seguradoras. Emitir seguro no Brasil exige autorização e capital regulatório, o que é uma barreira alta e explica por que o modelo mais comum é operar em parceria com uma seguradora que carrega o risco.
O que muda de verdade não é a interface bonita, é onde a decisão acontece. Seguro sempre foi um negócio de estatística: estimar a probabilidade de um evento e cobrar por ela. O que a tecnologia trouxe foi mais dado, mais rápido, e modelos capazes de usá-lo. É machine learning aplicado a um problema que já era, na origem, um problema de previsão.
Onde a IA já entrou na esteira
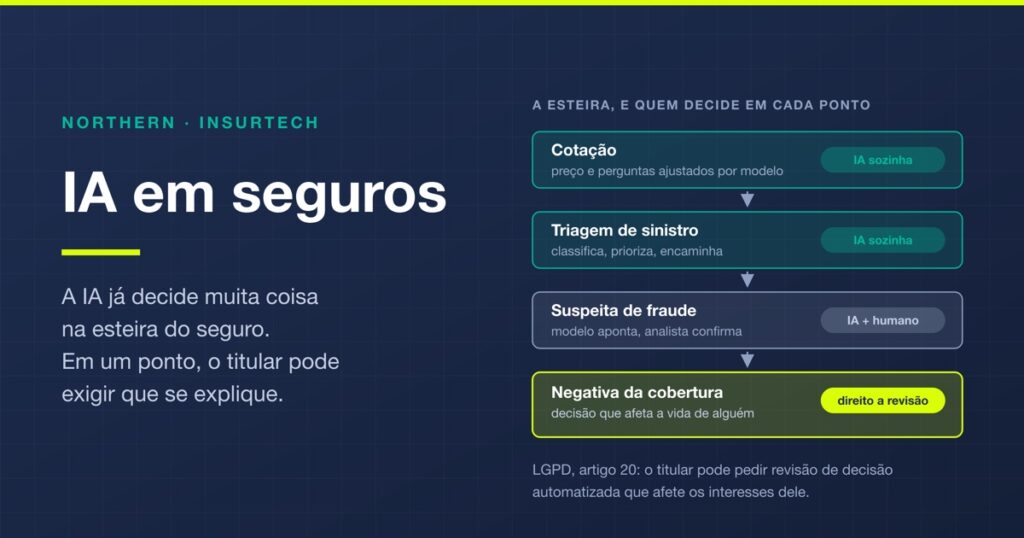
Separando promessa de operação, a IA está em produção principalmente em cinco pontos:
| Uso | O que faz | Quem decide |
|---|---|---|
| Cotação e subscrição | Estima risco e define preço a partir do perfil e do histórico | Modelo, dentro de faixas definidas |
| Triagem de sinistro | Classifica, prioriza e encaminha o aviso para a fila certa | Modelo |
| Detecção de fraude | Aponta padrões atípicos e casos para investigar | Modelo aponta, analista confirma |
| Análise de imagem | Estima dano em foto de veículo ou imóvel para orçar reparo | Modelo, com revisão nos casos altos |
| Atendimento | Responde dúvidas, avisa sinistro, acompanha status | Modelo, com escalonamento |
Repare no padrão da coluna da direita. Onde a decisão é operacional, a IA resolve sozinha e o ganho é de velocidade. Onde a decisão afeta o direito de alguém, aparece um humano no fluxo, e isso não é conservadorismo: é exigência legal, como a seção sobre regulação detalha.
O quinto item é o mais visível e o menos transformador. Um chatbot para empresas bem feito reduz fila e melhora a experiência, mas não muda a economia do negócio. Os itens um a três é que mexem no resultado.
Precificação e subscrição
Este é o ponto onde a IA tem mais efeito, porque ataca o núcleo do negócio: estimar quanto custa o risco de cada pessoa.
No modelo tradicional, o cálculo usa poucas variáveis e grupos amplos: idade, região, tipo de veículo, histórico declarado. Todo mundo dentro de um grupo paga parecido, o que significa que o cliente de baixo risco subsidia o de alto risco daquele mesmo grupo.
Com mais dados e modelos capazes de encontrar padrões, os grupos ficam menores e o preço se aproxima do risco individual. É análise preditiva aplicada a sinistralidade. Duas consequências, e a segunda raramente é dita:
- O bom risco fica mais barato. Quem dirige pouco e com cuidado deixa de pagar pelo comportamento médio do seu grupo. Modelos de telemetria, em que o prêmio varia com o uso real do veículo, existem justamente para isso.
- O mau risco fica mais caro, ou fica sem cobertura. Precificação muito precisa corrói o mutualismo que é a base do seguro. No limite, quem mais precisa de proteção é quem menos consegue pagar por ela, e essa é uma discussão regulatória aberta em vários países.
Quem constrói sistema para seguradora precisa entender que essa não é uma decisão técnica. É uma decisão de negócio com consequência social, e o time de tecnologia costuma ser o primeiro a enxergar o efeito nos números.
Sinistro e fraude
Sinistro é onde a seguradora gasta, e por isso é onde a eficiência aparece rápido.
Na triagem, o modelo lê o aviso, classifica o tipo de ocorrência, estima complexidade e encaminha. Casos simples e de valor baixo podem seguir por um fluxo automatizado de ponta a ponta, o que reduz o prazo de dias para horas. Casos complexos vão para o analista com o contexto já organizado.
Na fraude, o modelo compara o caso com o histórico e aponta o que destoa: coincidências de rede entre partes, padrões de valor, sequência temporal improvável. Aqui vale marcar uma distinção que costuma se perder: o modelo não detecta fraude, ele detecta anomalia. Nem toda anomalia é fraude, e uma parcela relevante dos casos apontados é apenas incomum. Por isso o desenho correto tem sempre um analista confirmando antes de qualquer consequência para o segurado.
É a diferença entre priorizar recall e priorizar precisão. Num sistema antifraude, deixar passar um caso custa dinheiro, e acusar um cliente honesto custa o cliente e, eventualmente, um processo. Definir qual dos dois erros é o caro precisa acontecer antes de treinar o modelo, não depois de ver o resultado.
O que a lei brasileira exige
Três camadas se aplicam a uma seguradora que automatiza decisão, e ignorar qualquer uma delas cria passivo.
A LGPD. Dado de sinistro, de saúde e de comportamento é dado pessoal, e parte dele é dado sensível, com regime mais rígido. O artigo 20 é o que importa mais aqui: o titular tem direito de solicitar a revisão de decisões tomadas unicamente com base em tratamento automatizado que afetem seus interesses. Vale a precisão: a redação original previa expressamente revisão por pessoa natural, e essa expressão saiu na conversão da medida provisória que alterou a lei. O direito à revisão permanece; o texto vigente não determina que ela seja feita por um humano. O mesmo artigo garante ainda o direito a informações sobre os critérios usados na decisão.
Na prática, isso significa duas obrigações de engenharia. A primeira é registrar por que o modelo decidiu o que decidiu, caso a caso, e não apenas o resultado. A segunda é ter um caminho de revisão que funcione de verdade, e não uma página de contato. As obrigações de segurança que acompanham isso são as mesmas descritas em o que a LGPD exige em segurança da informação.
A SUSEP. O setor é regulado, e a autoridade acompanha produto, precificação e conduta. Modelo de precificação não é caixa-preta perante o regulador: é preciso conseguir explicar como o preço se forma.
O direito do consumidor. Negativa de cobertura precisa de justificativa clara e compreensível. “O sistema recusou” não é justificativa.
O risco específico: viés que vira preço
Todo modelo aprende do histórico, inclusive o que não deveria. Em seguros esse problema tem uma gravidade particular, porque o resultado do modelo não é uma recomendação, é o preço que a pessoa paga ou a recusa que ela recebe.
O mecanismo mais perigoso é a discriminação por procuração: o modelo não usa uma variável proibida, mas usa outra que funciona como substituta dela. CEP correlaciona com renda e com raça. Modelo de celular correlaciona com classe social. Horário de acesso correlaciona com tipo de trabalho. Nenhuma dessas variáveis é ilegal por si, e o conjunto delas pode reproduzir exatamente a discriminação que a lei proíbe, com aparência de neutralidade estatística.
Três controles reduzem isso, e nenhum é caro:
- Testar o resultado por grupo. Comparar taxa de aprovação e preço médio entre recortes demográficos. Diferença grande e inexplicada é sinal para investigar, não para justificar.
- Auditar as variáveis por proximidade. Para cada atributo do modelo, perguntar do que ele é substituto. Se a resposta for uma característica protegida, ele sai.
- Manter explicabilidade. Modelo que ninguém consegue explicar é indefensável perante o regulador e perante o cliente, por melhor que seja o número.
Por onde uma seguradora começa
A sequência que funciona é a menos glamourosa, e começa longe do modelo.
O primeiro passo é olhar o dado que já existe. Seguradora costuma ter décadas de histórico de apólice e sinistro em sistemas antigos, mal integrados e cheios de campo livre preenchido à mão. Antes de treinar qualquer coisa, é preciso conseguir ler isso de forma consistente, e essa costuma ser a maior parte do trabalho e do orçamento.
O segundo é escolher um caso de uso com resultado mensurável e risco baixo. Triagem de sinistro é o candidato clássico: o ganho aparece em dias de prazo, o erro é reversível, e ninguém tem direito negado por causa dele. Precificação é o oposto: maior retorno, maior exposição regulatória, e não é por onde se começa.
O terceiro é montar o processo de revisão antes de ligar o modelo. Quem revisa, com que prazo, com base em qual informação. Construir isso depois, sob reclamação de cliente, custa muito mais caro.
Nada disso é diferente do que vale para qualquer projeto de inteligência artificial em ambiente regulado, e todas essas perguntas pertencem à definição de escopo, antes da primeira linha de código. Em seguros elas só custam mais caro quando ignoradas, porque o erro chega ao cliente na forma de preço ou de negativa.
Perguntas frequentes
O que é insurtech?
É a contração de insurance com technology, no mesmo molde de fintech. Designa tanto as empresas nascidas digitais que atuam em seguro quanto a transformação tecnológica dentro das seguradoras já estabelecidas. O que muda de verdade não é a interface, é onde a decisão acontece: seguro sempre foi um negócio de estimar probabilidade, e a tecnologia trouxe mais dado e modelos capazes de usá-lo.
Insurtech é o mesmo que seguradora digital?
Não. Boa parte das insurtechs brasileiras não emite apólice própria: são corretoras digitais, plataformas de distribuição ou fornecedores de tecnologia que vendem para seguradoras. Emitir seguro no Brasil exige autorização e capital regulatório, o que é uma barreira alta e explica por que o modelo mais comum é operar em parceria com uma seguradora que carrega o risco.
Onde a inteligência artificial já é usada em seguradoras?
Em cinco pontos principais: cotação e subscrição, estimando risco e definindo preço; triagem de sinistro, classificando e encaminhando avisos; detecção de fraude, apontando padrões atípicos; análise de imagem, estimando dano em fotos de veículo ou imóvel; e atendimento. Onde a decisão é operacional, o modelo resolve sozinho. Onde ela afeta o direito de alguém, aparece um humano no fluxo.
Como a IA muda a precificação de seguros?
No modelo tradicional o cálculo usa poucas variáveis e grupos amplos, então o cliente de baixo risco subsidia o de alto risco do mesmo grupo. Com mais dados, os grupos ficam menores e o preço se aproxima do risco individual. O bom risco fica mais barato. Mas o mau risco fica mais caro ou sem cobertura, e precificação muito precisa corrói o mutualismo que é a base do seguro.
A LGPD permite decisão automatizada em seguros?
Permite, com obrigações. O artigo 20 dá ao titular o direito de solicitar revisão de decisões tomadas unicamente com base em tratamento automatizado que afetem seus interesses, além de direito a informações sobre os critérios usados. Vale a precisão: a redação original previa revisão por pessoa natural, e essa expressão saiu na conversão da medida provisória. O direito à revisão permanece, mas o texto vigente não determina que ela seja feita por um humano.
O que a seguradora precisa registrar para cumprir a LGPD?
Duas coisas do ponto de vista de engenharia. Primeiro, registrar por que o modelo decidiu o que decidiu, caso a caso, e não apenas o resultado, porque o titular tem direito a informações sobre os critérios. Segundo, ter um caminho de revisão que funcione de verdade, com responsável e prazo definidos, e não uma página de contato genérica.
Como a IA detecta fraude em seguros?
Comparando o caso com o histórico e apontando o que destoa: coincidências de rede entre as partes, padrões de valor, sequência temporal improvável. Vale marcar uma distinção que costuma se perder: o modelo não detecta fraude, detecta anomalia. Nem toda anomalia é fraude, e por isso o desenho correto tem sempre um analista confirmando antes de qualquer consequência para o segurado.
O que é viés algorítmico em seguros?
É o modelo reproduzir discriminação aprendida do histórico. O mecanismo mais perigoso é a discriminação por procuração: o modelo não usa uma variável proibida, mas usa outra que funciona como substituta. CEP correlaciona com renda e raça, modelo de celular correlaciona com classe social. Nenhuma é ilegal isoladamente, e o conjunto pode reproduzir a discriminação que a lei proíbe com aparência de neutralidade estatística.
Como evitar viés em modelos de precificação?
Três controles, nenhum caro. Testar o resultado por grupo, comparando taxa de aprovação e preço médio entre recortes demográficos, e investigar diferenças grandes e inexplicadas. Auditar cada variável perguntando do que ela é substituta, removendo as que representam características protegidas. E manter explicabilidade, porque modelo que ninguém consegue explicar é indefensável perante o regulador e perante o cliente.
Por onde uma seguradora deve começar com IA?
Pelo dado que já existe: seguradora costuma ter décadas de histórico em sistemas antigos, mal integrados e cheios de campo livre, e organizar isso costuma ser a maior parte do trabalho. Depois, escolher um caso de uso mensurável e de risco baixo, como triagem de sinistro, onde o ganho aparece em prazo e o erro é reversível. Precificação é o oposto, com maior retorno e maior exposição regulatória, e não é por onde se começa.