Preparar os dados para IA é decidir três coisas antes de contratar qualquer ferramenta: onde cada número mora, o que exatamente ele significa e quem responde por ele. Nenhuma das três é trabalho de tecnologia, e é por isso que a maioria dos projetos descobre o problema tarde, depois de já ter pago licença.
Este texto descreve o que precisa estar pronto, o que pode ficar para depois e como saber em qual dos dois grupos cada pendência está. A lista é curta de propósito: exigir base impecável antes de começar trava o projeto para sempre, e aceitar qualquer coisa produz resposta errada com aparência de resposta certa.
Dado pronto não é dado em volume
A primeira confusão é achar que o problema é quantidade. Empresa de porte médio costuma ter dado demais, não de menos: anos de histórico em ERP, planilhas paralelas, conversas de atendimento, contratos em PDF. O que falta não é matéria-prima, é ordem.
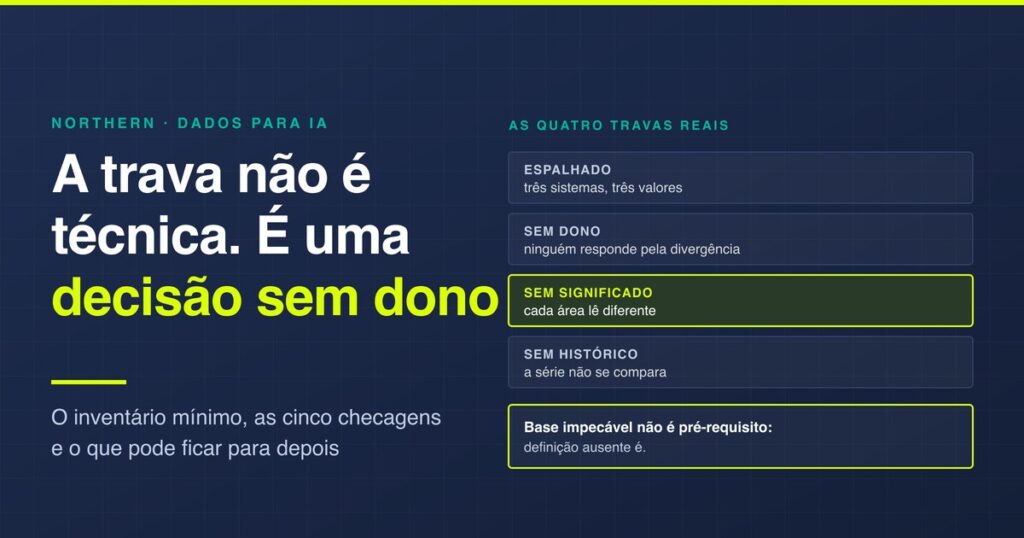
A segunda é achar que o problema é técnico. Quase toda trava que aparece em projeto de IA é uma decisão de negócio que ninguém tomou: se cliente inativo entra ou não no cálculo, se devolução abate do faturamento do mês da venda ou do mês da devolução, se o time de campo conta como despesa comercial. Enquanto essas respostas não existem, nenhum modelo consegue inventá-las, e ele vai responder com alguma coisa mesmo assim. É a raiz de boa parte dos casos descritos em por que a inteligência artificial falha nas empresas.
As quatro travas reais
- Dado espalhado. A mesma informação vive em três sistemas com três valores. Não há erro em nenhum deles isoladamente, e é justamente isso que torna a divergência difícil de resolver.
- Dado sem dono. Existe o número, mas não existe quem responde quando ele diverge. Sem essa pessoa, a discussão vira reunião recorrente e nunca vira definição.
- Dado sem significado escrito. Todo mundo usa a palavra “cliente ativo” e cada área entende uma coisa. O modelo herda a ambiguidade e a amplifica.
- Dado sem histórico utilizável. Há registro, mas ele mudou de formato duas vezes, e a série não é comparável com ela mesma.
As quatro aparecem juntas com frequência, e a ordem de ataque importa: significado primeiro, dono em seguida, consolidação depois. Consolidar antes de definir significado só produz uma base grande e igualmente ambígua.
O inventário mínimo
Antes de mexer em qualquer coisa, vale montar uma lista de uma página com quatro colunas: qual informação, em que sistema ela nasce, quem responde por ela e com que frequência ela muda. Não é documento de arquitetura, é um mapa de conversa.
O critério para entrar na lista é utilidade, não completude. Comece pelas informações que aparecem na pergunta que motivou o projeto. Se a ideia é prever demanda, entram vendas, estoque, prazo de reposição e calendário comercial. Não entram folha de pagamento e contratos, por mais organizados que estejam.
Esse inventário costuma revelar, sozinho, que o projeto não é de IA. Quando a lista mostra que a informação existe e só não está reunida, o caminho mais barato é integração de sistemas ou um painel, tratado em business intelligence para empresas. Descobrir isso na primeira semana custa uma tarde; descobrir depois da contratação custa o contrato inteiro.
Definir o significado antes do modelo
Esta é a etapa que parece burocrática e é a que decide o resultado. Para cada informação da lista, é preciso uma frase escrita que qualquer pessoa da empresa leia e aplique do mesmo jeito.
“Cliente ativo” não serve. “Cliente com pelo menos uma compra faturada nos últimos 180 dias, excluindo devoluções integrais” serve. A diferença entre as duas é a diferença entre um número que sustenta decisão e um número que gera reunião.
Vale escrever as definições em um único lugar acessível, com data e responsável. Quando a definição muda, o que muda junto é a série histórica, e sem registro ninguém consegue explicar por que o indicador saltou. Esse é o miolo do que se chama governança de dados, e é pré-requisito de IA pelo mesmo motivo que é pré-requisito de painel: modelo nenhum resolve ambiguidade de definição.
As cinco checagens de qualidade
- Completude. Que percentual dos registros tem preenchido o campo que o projeto vai usar. Abaixo de 80% em um campo central, o projeto precisa de uma etapa de preenchimento antes.
- Duplicidade. O mesmo cliente aparece quantas vezes com grafias diferentes. Cadastro duplicado infla contagem e destrói qualquer cálculo por cliente.
- Consistência de unidade. Valores em moedas diferentes, pesos em unidades diferentes, datas em formatos diferentes. É o erro mais silencioso da lista.
- Coerência temporal. A data registrada é a do fato ou a do lançamento no sistema. Quando as duas se misturam, toda análise de prazo fica errada.
- Valores impossíveis. Prazo negativo, idade de 300 anos, venda em data futura. Servem de termômetro: muitos deles indicam entrada manual sem validação na origem.
Nenhuma das cinco exige ferramenta. Todas se respondem com consulta simples sobre a base que já existe, e o resultado costuma ser mais útil que o diagnóstico que um fornecedor faria cobrando.
Quanto passado é necessário
Depende do que se pretende fazer, e a resposta honesta é mais curta do que se imagina. Para classificar ou organizar texto, como contrato, chamado e mensagem de atendimento, o histórico quase não importa: o que importa é ter exemplos bem rotulados do que é cada coisa.
Para previsão, importa muito, e o piso prático é ter dois ciclos completos do fenômeno. Negócio com sazonalidade anual precisa de dois anos, não de dois meses com muito volume. E se no meio desse período houve troca de sistema, mudança de política comercial ou pandemia, a série precisa ser tratada antes, ou o modelo vai aprender o evento em vez do padrão. A lógica é a mesma de análise preditiva, que vive do mesmo insumo.
Acesso, permissão e o que não pode sair
Antes de qualquer piloto, três respostas precisam estar escritas: quais informações não podem sair do ambiente da empresa, quem pode consultar o quê, e o que acontece com o dado enviado a um fornecedor. A terceira é a mais esquecida, e é a que aparece depois como problema jurídico.
O caminho prático é separar a base em três faixas: o que pode ir para qualquer serviço, o que só vai anonimizado, e o que não sai. Fazer essa separação uma vez, no começo, evita a decisão caso a caso feita sob pressão de prazo. O detalhamento da parte legal está em LGPD e IA, e a regra que transforma isso em rotina, em governança de IA. Nenhum dos dois substitui a conversa com quem responde por dados pessoais na empresa.
O que pode ficar para depois
Exigir perfeição é a forma mais comum de nunca começar, então vale dizer o que não bloqueia. Não bloqueia ter dado bagunçado em áreas que não entram no primeiro caso de uso. Não bloqueia falta de data warehouse: ele resolve escala e repetição, não viabilidade, e a discussão de quando ele se justifica está em data warehouse.
Também não bloqueia ausência de time de dados. O primeiro caso de uso costuma caber em uma pessoa de negócio que conhece o processo e alguém que consulte a base. O que bloqueia, sempre, são as definições ausentes e o dado central em branco, porque os dois produzem resposta confiante e errada, que é o pior resultado possível.
Por onde seguir
Com o inventário e as definições prontos, a pergunta seguinte é onde aplicar primeiro, e o critério de escolha está em IA para empresas. Se a aplicação pretendida for conversa com cliente, os limites práticos aparecem em agentes de IA e em o que é chatbot. Se for leitura de número para decisão, o recorte é IA para análise de dados. Antes de aprovar orçamento, vale comparar o custo das etapas de preparo com o do projeto em si, em quanto custa criar uma IA. E se o inventário revelar que o ativo organizado aqui vale como produto, e não apenas como melhoria interna, a pergunta passa a ser de portfólio, tratada em estratégia de produto.
Perguntas frequentes
O que significa preparar os dados para IA?
É decidir três coisas antes de contratar ferramenta: onde cada informação nasce, o que exatamente ela significa e quem responde por ela quando diverge. Nenhuma das três é trabalho de tecnologia, e é por isso que a maioria dos projetos descobre o problema tarde, depois de já ter pago licença.
Quantos dados são necessários para usar IA?
Depende do uso, e o piso é menor do que se imagina. Para classificar ou organizar texto, o volume quase não importa: importa ter exemplos bem rotulados. Para previsão, o piso prático é ter dois ciclos completos do fenômeno, então negócio com sazonalidade anual precisa de dois anos, não de dois meses com muito volume.
Preciso de um data warehouse antes de fazer IA?
Não. O data warehouse resolve escala e repetição, não viabilidade. O primeiro caso de uso costuma rodar sobre a base que já existe. O que bloqueia de verdade é definição ausente e campo central em branco, porque os dois produzem resposta confiante e errada, que é o pior resultado possível.
Quais são os problemas mais comuns na base de dados?
Quatro. Dado espalhado, quando a mesma informação vive em três sistemas com três valores. Dado sem dono, quando não existe quem responde pela divergência. Dado sem significado escrito, quando cada área entende uma coisa por cliente ativo. E histórico que mudou de formato, e por isso não é comparável com ele mesmo.
Por onde começar a organizar os dados?
Por uma lista de uma página com quatro colunas: qual informação, em que sistema ela nasce, quem responde por ela e com que frequência muda. O critério para entrar é utilidade, não completude, então só entram as informações que aparecem na pergunta que motivou o projeto.
Como escrever a definição de um indicador?
De forma que qualquer pessoa da empresa leia e aplique do mesmo jeito. Cliente ativo não serve. Cliente com pelo menos uma compra faturada nos últimos 180 dias, excluindo devoluções integrais, serve. A diferença entre as duas é a diferença entre um número que sustenta decisão e um número que gera reunião.
Como avaliar a qualidade dos dados sem ferramenta?
Com cinco checagens feitas por consulta simples: completude do campo que o projeto vai usar, duplicidade de cadastro, consistência de unidade e de formato de data, coerência entre a data do fato e a do lançamento, e presença de valores impossíveis como prazo negativo ou venda em data futura.
Dado bagunçado impede começar um projeto de IA?
Só se a bagunça estiver na área que entra no primeiro caso de uso. Bagunça em outras áreas não bloqueia, falta de data warehouse não bloqueia e ausência de time de dados não bloqueia. Exigir base impecável antes de começar é a forma mais comum de nunca começar.
O que precisa ser decidido sobre acesso e privacidade?
Três respostas, escritas antes do piloto: quais informações não podem sair do ambiente da empresa, quem pode consultar o quê e o que acontece com o dado enviado a um fornecedor. O caminho prático é separar a base em três faixas, o que pode ir para qualquer serviço, o que só vai anonimizado e o que não sai.
E se o inventário mostrar que não é caso de IA?
É um bom resultado, e acontece com frequência. Quando a lista mostra que a informação existe e só não está reunida, o caminho mais barato é integração de sistemas ou um painel. Descobrir isso na primeira semana custa uma tarde; descobrir depois da contratação custa o contrato inteiro.