Underfitting é quando o modelo é simples demais para o padrão que existe nos dados: ele erra no teste e erra também no treino, o que é o sinal mais fácil de reconhecer em aprendizado de máquina. A imagem que resolve a explicação é uma reta tentando descrever uma curva. Ela não decora nada, e também não acerta nada.
O oposto é o overfitting, em que o modelo decora o treino e falha no mundo real. Os dois são erros de ajuste, e este texto mostra como diferenciá-los com dois números, o que causa cada um e o que fazer a respeito.
O diagnóstico com dois números
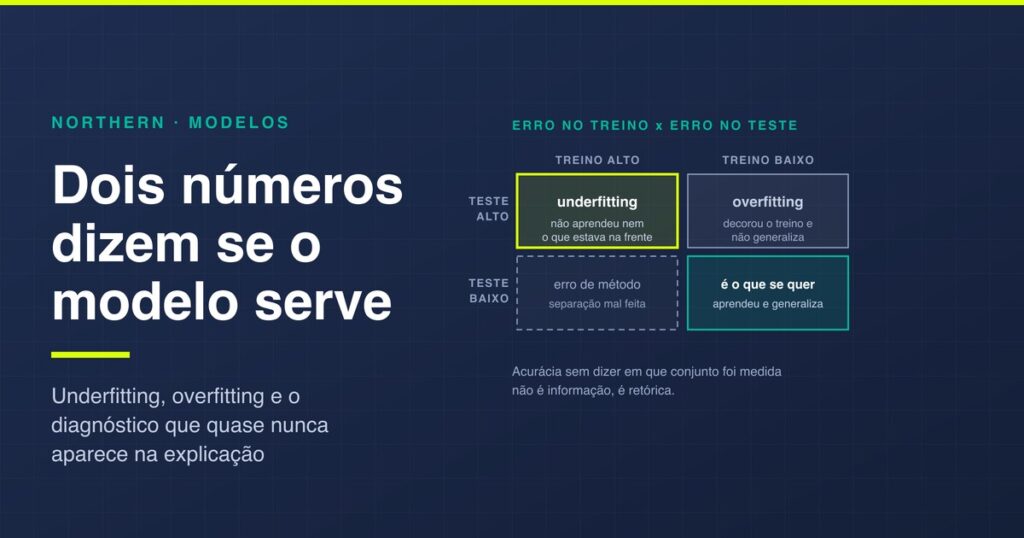
Todo modelo é avaliado em dois conjuntos: o de treino, que ele viu, e o de teste, que ele não viu. Comparar os dois erros diz imediatamente o que está acontecendo:
| Erro no treino | Erro no teste | Diagnóstico |
|---|---|---|
| alto | alto | underfitting: o modelo não aprendeu nem o que estava na frente dele |
| baixo | alto | overfitting: decorou o treino e não generaliza |
| baixo | baixo | o que se quer: aprendeu o padrão e ele vale fora da amostra |
| alto | baixo | quase sempre erro de metodologia, com separação de dados mal feita |
Essa tabela é a coisa mais útil de todo o assunto, e é a que quase nunca aparece na explicação de underfitting. Sem separar treino de teste, não existe diagnóstico: um modelo que acerta tudo no material que viu pode ser excelente ou inútil, e os dois casos têm a mesma aparência.
Viés e variância, sem matemática
Os dois erros de ajuste têm nomes técnicos que ajudam a lembrar do problema. Viés alto é o modelo teimoso: ele traz uma suposição rígida demais sobre a forma do padrão e não muda de ideia com os dados, e isso é o underfitting. Variância alta é o modelo influenciável: qualquer detalhe do treino muda o comportamento dele, o que é o overfitting.
Existe uma troca entre os dois: reduzir um tende a aumentar o outro, e o trabalho é encontrar o meio. Na prática, o meio se acha por tentativa medida, comparando o erro nos dois conjuntos a cada mudança, e não por escolha teórica de algoritmo.
O que causa underfitting
- Modelo simples demais para o problema. Uma relação que claramente não é reta descrita por uma reta é o caso escolar, e acontece de verdade quando alguém escolhe o algoritmo pela facilidade.
- Variáveis insuficientes. Prever venda sem saber preço, mês e canal é pedir o impossível: a informação que explicaria o padrão não está na tabela.
- Restrição excessiva. As técnicas que servem para conter overfitting, quando exageradas, produzem o problema oposto. É o erro mais comum de quem já foi mordido por um modelo que decorava.
- Treino curto demais. O modelo parou antes de aprender, o que aparece em treinamento interrompido cedo para economizar tempo ou custo.
- Dado mal preparado. Escala muito diferente entre variáveis, categoria mal codificada e valor faltante tratado de qualquer jeito atrapalham o aprendizado antes de qualquer escolha de modelo.
Como corrigir
- Melhore as variáveis antes de trocar o modelo. Acrescentar a informação que faltava resolve mais casos que qualquer algoritmo novo, e é onde está o conhecimento de quem entende do negócio.
- Use um modelo mais expressivo, capaz de representar relação não linear e interação entre variáveis.
- Reduza a restrição que estava limitando o aprendizado, verificando a cada passo se o erro de teste acompanha o de treino.
- Treine mais, quando o processo tiver sido interrompido antes da hora.
- Reveja a preparação do dado, com escala, categoria e ausência tratadas de forma consistente.
Uma boa notícia: underfitting é o mais fácil dos dois de corrigir, porque o problema é falta de capacidade e capacidade se acrescenta. Overfitting exige disciplina para tirar coisa, o que costuma doer mais em quem construiu o modelo. Vale seguir uma ordem ao corrigir, mudando uma coisa por vez e registrando os dois erros a cada passo: quem mexe em três parâmetros juntos não sabe qual deles ajudou, e costuma voltar ao ponto de partida na semana seguinte.
Um exemplo com números
Uma loja quer prever a venda semanal de um produto. O histórico mostra que a venda sobe no fim do mês e dobra em datas comemorativas.
- Modelo subajustado: usa só a média das últimas semanas. Erra 30% no treino e 32% no teste, e os dois números próximos e altos são a assinatura do underfitting. Ele ignora fim de mês e data comemorativa porque não recebeu essa informação.
- Modelo sobreajustado: recebe trinta variáveis, incluindo temperatura do dia e número do dia no calendário, e memoriza as combinações. Erra 3% no treino e 40% no teste. Parece brilhante para quem só olha o primeiro número.
- Modelo equilibrado: usa semana do mês, indicador de data comemorativa, preço praticado e média recente. Erra 12% no treino e 14% no teste, e é o único dos três que serve para decidir compra.
Repare que o modelo do meio, o que erra menos no treino, é o pior dos três na prática. É por isso que apresentar acurácia sem dizer em que conjunto ela foi medida não é informação, é retórica.
O que isso significa em um projeto de empresa
Quem contrata não vai ajustar hiperparâmetro, mas precisa saber o que perguntar quando recebe um modelo:
- Qual o erro no treino e no teste? Se vier um número só, ele não diz nada. Dois números contam a história inteira.
- Como os dados foram separados? Em previsão que envolve tempo, o teste tem que ser o período seguinte, e não uma amostra aleatória do mesmo período, senão o modelo espia o futuro.
- Qual a comparação com o método atual? A régua é o que a empresa faz hoje, normalmente a estimativa de alguém experiente.
- O que acontece quando o mundo muda? Modelo que dependia de um padrão sazonal precisa de reavaliação depois de qualquer mudança grande de preço, produto ou mercado.
Essas quatro perguntas separam entrega séria de apresentação bonita, e valem para qualquer fornecedor, como está em quanto custa criar uma IA.
Quando o modelo simples é o certo
Existe um caso em que o modelo aparentemente subajustado é a resposta correta, e ele é pouco comentado: quando o sinal nos dados é genuinamente fraco. Se o histórico não explica o resultado, um modelo que promete explicar está decorando ruído, e a honestidade técnica é entregar a previsão modesta com a margem de erro real.
Modelo simples também ganha quando a decisão precisa ser explicada caso a caso, quando o volume de dado é pequeno e quando alguém vai manter aquilo por anos. Nessas situações, um modelo transparente e um pouco pior é melhor negócio que um modelo opaco e um pouco melhor.
Para o outro lado da moeda, vale o que é overfitting. Para entender onde esses erros aparecem em previsão de negócio, análise preditiva, e para o mapa das categorias, tipos de IA e o que é inteligência artificial. Se o projeto ainda está sendo desenhado, o recorte vem antes: como definir o escopo do primeiro produto digital.
Perguntas frequentes
O que é underfitting?
É quando o modelo é simples demais para o padrão que existe nos dados: ele erra no teste e erra também no treino. A imagem que resolve a explicação é uma reta tentando descrever uma curva, que não decora nada e também não acerta nada. Tecnicamente é o caso de viés alto: o modelo traz uma suposição rígida demais sobre a forma do padrão e não muda de ideia com os dados.
Qual a diferença entre underfitting e overfitting?
A diferença aparece ao comparar dois números. Erro alto no treino e alto no teste é underfitting: o modelo não aprendeu nem o que estava na frente dele. Erro baixo no treino e alto no teste é overfitting: decorou o material que viu e não generaliza. Erro baixo nos dois é o que se quer. E erro alto no treino com baixo no teste quase sempre indica erro de metodologia na separação dos dados.
Como identificar underfitting na prática?
Medindo o erro nos dois conjuntos, o de treino que o modelo viu e o de teste que ele não viu. Quando os dois erros são altos e próximos, é underfitting. Sem essa separação não existe diagnóstico possível: um modelo que acerta tudo no material que viu pode ser excelente ou inútil, e os dois casos têm exatamente a mesma aparência.
O que causa underfitting?
Cinco causas cobrem quase tudo: modelo simples demais para o problema; variáveis insuficientes, como tentar prever venda sem saber preço, mês e canal; restrição excessiva, que é o excesso das técnicas usadas para conter overfitting; treino interrompido antes da hora; e dado mal preparado, com escala muito diferente entre variáveis e valor faltante tratado de qualquer jeito.
Como corrigir underfitting?
Comece melhorando as variáveis, porque acrescentar a informação que faltava resolve mais casos que trocar de algoritmo, e é onde entra o conhecimento de quem entende do negócio. Depois use um modelo mais expressivo, reduza a restrição que limitava o aprendizado, treine mais se o processo foi interrompido e revise a preparação do dado. Mude uma coisa por vez, registrando os dois erros a cada passo.
O que é viés e variância?
São os nomes técnicos dos dois problemas. Viés alto é o modelo teimoso, com suposição rígida demais sobre o padrão, o que produz underfitting. Variância alta é o modelo influenciável, em que qualquer detalhe do treino muda o comportamento, o que produz overfitting. Existe uma troca entre os dois: reduzir um tende a aumentar o outro, e o meio se encontra por tentativa medida, não por escolha teórica.
Underfitting é pior que overfitting?
É mais fácil de corrigir, porque o problema é falta de capacidade e capacidade se acrescenta. Overfitting exige disciplina para tirar coisa, o que costuma doer mais em quem construiu o modelo. Em termos de risco, o overfitting é mais perigoso na prática, porque ele se apresenta com números excelentes no treino e engana quem só olha o primeiro número.
O que perguntar quando recebo um modelo de um fornecedor?
Quatro perguntas. Qual o erro no treino e no teste, porque um número só não diz nada. Como os dados foram separados, já que em previsão com tempo o teste precisa ser o período seguinte, e não uma amostra aleatória do mesmo período. Qual a comparação com o método atual da empresa. E o que acontece quando o mundo muda, porque modelo que dependia de padrão sazonal precisa de reavaliação depois de mudança grande.
Existe caso em que o modelo simples é o certo?
Existe, e é pouco comentado: quando o sinal nos dados é genuinamente fraco. Se o histórico não explica o resultado, um modelo que promete explicar está decorando ruído, e a honestidade técnica é entregar a previsão modesta com a margem de erro real. Modelo simples também ganha quando a decisão precisa ser explicada caso a caso, quando o volume de dado é pequeno e quando alguém vai manter aquilo por anos.
Por que acurácia sozinha não serve como medida?
Porque ela não diz em que conjunto foi medida. Um modelo com trinta variáveis pode errar 3% no treino e 40% no teste, parecendo brilhante para quem só olha o primeiro número, enquanto um modelo equilibrado erra 12% e 14% e é o único que serve para decidir. Apresentar acurácia sem dizer onde foi medida não é informação, é retórica.