Machine learning, ou aprendizado de máquina, é o campo em que a máquina descobre as regras sozinha, a partir de exemplos, em vez de recebê-las escritas por alguém. Essa frase parece vaga até você olhar o que muda na prática, e o que muda é a ordem das peças.
Este texto percorre a mecânica: a inversão que define o campo, onde ele fica em relação à inteligência artificial e ao deep learning, os três tipos de aprendizado, como um modelo é treinado, o que dá errado e quais métricas realmente dizem se funcionou.
A inversão que define o campo
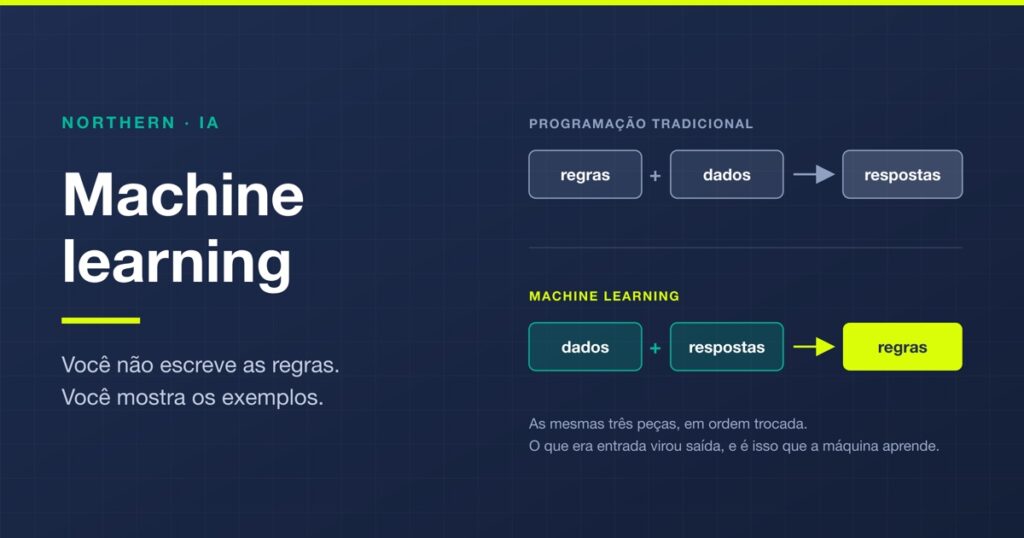
Em programação tradicional, você escreve as regras. O programa recebe regras mais dados e devolve respostas. Para detectar spam assim, alguém precisa listar: se contém certa palavra, se vem de certo domínio, se tem excesso de links. A lista nunca fica pronta, porque quem manda spam muda o texto na semana seguinte.
Machine learning troca a ordem. O sistema recebe dados mais respostas e devolve as regras. Você entrega milhares de mensagens já marcadas como spam ou não spam, e o algoritmo encontra sozinho os padrões que separam os dois grupos. Ninguém escreve a regra, e ninguém consegue enumerá-la depois: ela existe como um conjunto de pesos ajustados.
Daí saem as duas consequências que importam para quem decide. A primeira é que sem dado rotulado não há aprendizado: o insumo é histórico com resposta conhecida, e ele costuma ser o gargalo real do projeto. A segunda é que o modelo aprende o que está nos dados, inclusive o que não deveria. Histórico enviesado produz modelo enviesado, com a aparência de neutralidade que um número carrega.
IA, machine learning e deep learning
Os três termos aparecem como sinônimos e não são. Eles são círculos concêntricos:
| Termo | O que abrange |
|---|---|
| Inteligência artificial | O campo inteiro: qualquer técnica que faça a máquina executar tarefas associadas à inteligência humana, incluindo sistemas de regras escritas à mão, sem aprendizado nenhum |
| Machine learning | O subconjunto em que o comportamento é aprendido a partir de dados, e não programado |
| Deep learning | O subconjunto do machine learning que usa redes neurais com muitas camadas, capazes de aprender representações direto de dado bruto como imagem, áudio e texto |
Todo deep learning é machine learning, e todo machine learning é IA. O contrário não vale: um sistema especialista dos anos 1980, com regras escritas por humanos, é IA e não é machine learning. Se você quer o quadro completo do campo maior, ele está em o que é inteligência artificial, e o detalhamento das redes profundas em o que é deep learning.
Vale situar o que dominou a conversa recente: os modelos de linguagem por trás dos assistentes atuais são deep learning. São redes neurais muito grandes, treinadas em volumes enormes de texto para prever a próxima palavra, e é dessa tarefa simples repetida em escala que emerge o resto. Continuam sendo, na base, a mesma inversão descrita acima.
Os três tipos de aprendizado
A diferença entre eles está no que acompanha os dados na hora do treino:
- Supervisionado. Cada exemplo vem com a resposta certa. É o mais usado em empresa, e cobre duas tarefas: classificação, quando a resposta é uma categoria (é spam ou não), e regressão, quando é um número (quanto este imóvel vale). Previsão de cancelamento de cliente, aprovação de crédito e análise preditiva em geral caem aqui.
- Não supervisionado. Os dados não vêm com resposta. O algoritmo procura estrutura sozinho: agrupa clientes com comportamento parecido, reduz dimensões, encontra o que destoa do padrão. Serve para descobrir segmentos que ninguém tinha definido, e para detecção de anomalia.
- Por reforço. Não há resposta certa, há recompensa. O sistema tenta, recebe pontuação e ajusta a estratégia para maximizar o resultado ao longo do tempo. Foi assim que, em 2015, um algoritmo do DeepMind aprendeu a jogar Atari partindo de zero: começa errando o básico e, depois de horas jogando, encontra estratégias que os projetistas não previram.
Um erro comum é escolher a técnica antes de olhar o dado disponível. O tipo de aprendizado é consequência do que existe: com histórico rotulado, supervisionado; sem rótulo, não supervisionado; com um ambiente onde é barato tentar e medir, reforço.
Como um modelo é treinado
O ciclo é sempre o mesmo, e nenhuma etapa é dispensável:
- Preparar os dados. Limpar, tratar valores ausentes e escolher as variáveis que entram, chamadas de atributos ou features. Costuma consumir a maior parte do tempo do projeto, e é onde a qualidade se decide.
- Separar os conjuntos. Uma parte para treinar, uma para validar durante os ajustes e uma para o teste final, que o modelo nunca viu. Sem essa separação, não existe medida honesta de desempenho.
- Treinar. O algoritmo ajusta seus parâmetros para reduzir o erro entre a resposta que produz e a resposta conhecida.
- Avaliar. Medir no conjunto de teste, com uma métrica escolhida antes, e não a que der o número mais bonito depois.
- Monitorar em produção. O mundo muda e o modelo não. Desempenho cai com o tempo à medida que os dados novos deixam de parecer com os de treino, o que exige retreino periódico.
O último item é o mais esquecido, e o que transforma um bom projeto em um sistema que apodrece em silêncio. Modelo em produção sem monitoramento continua respondendo com a mesma confiança de sempre enquanto acerta cada vez menos.
Quando o modelo não aprende
Existem duas formas simétricas de falhar, e reconhecê-las é o básico do diagnóstico:
| O que acontece | Como se manifesta | |
|---|---|---|
| Overfitting | O modelo decora o conjunto de treino, inclusive o ruído | Acerta quase tudo no treino e erra feio em dado novo |
| Underfitting | O modelo é simples demais para o padrão existente | Vai mal no treino e mal no teste, de forma parecida |
O primeiro é o mais perigoso porque se disfarça de sucesso: os números da apresentação ficam ótimos, e o sistema quebra quando encontra o mundo real. Os dois têm tratamento conhecido, detalhado em o que é overfitting e em o que é underfitting.
As métricas, e por que a acurácia engana
A métrica mais intuitiva é a acurácia: a proporção de acertos sobre o total. E ela é péssima quando as classes são desbalanceadas, que é o caso da maioria dos problemas úteis.
Imagine detectar uma fraude que ocorre em 1% das transações. Um modelo que responde “não é fraude” para absolutamente tudo tem 99% de acurácia e não serve para nada. O número está certo e a conclusão está errada, que é a pior combinação possível num relatório.
Por isso se olha a matriz de confusão, que separa os quatro casos: verdadeiro positivo, falso positivo, verdadeiro negativo e falso negativo. Dela saem as métricas que importam:
| Métrica | Responde | Cálculo |
|---|---|---|
| Precisão | Dos que apontei como positivos, quantos eram mesmo? | VP / (VP + FP) |
| Recall (sensibilidade) | Dos positivos que existiam, quantos eu encontrei? | VP / (VP + FN) |
| F1 | Um número só, equilibrando as duas | Média harmônica de precisão e recall |
As duas primeiras se opõem, e escolher entre elas é decisão de negócio, não de técnica. Num exame que detecta doença grave, o falso negativo é o erro caro: manda para casa quem está doente. Ali se prioriza recall, aceitando alarmes falsos. Num filtro de spam, o falso positivo é o caro: joga fora o e-mail do cliente. Ali se prioriza precisão.
Definir qual erro dói mais antes de treinar é o que separa um projeto conduzido de um projeto que persegue o número mais alto que aparecer.
Quando machine learning resolve
Machine learning vale quando quatro condições aparecem juntas. Falhando uma, o custo raramente se paga:
- Existe padrão nos dados. Se o fenômeno é aleatório, nenhum algoritmo encontra o que não está lá.
- A regra é difícil de escrever à mão. Reconhecer um rosto é difícil de descrever e fácil de exemplificar. Calcular imposto é o oposto, e pede código comum.
- Há volume histórico com resposta conhecida. Poucas dezenas de exemplos não sustentam aprendizado.
- Errar às vezes é aceitável. Todo modelo erra. Se o processo exige acerto garantido, o lugar dele é apoiando a decisão, não decidindo.
O item três costuma ser o que derruba a ideia, e o diagnóstico honesto no começo evita meses gastos. Por isso a pergunta sobre dado disponível pertence à definição de escopo do produto, e não à fase de implementação. Muito problema apresentado como caso de machine learning se resolve com uma consulta bem feita ao banco, e sai mais barato e mais explicável.
Perguntas frequentes
O que é machine learning?
É o campo em que a máquina descobre as regras sozinha, a partir de exemplos, em vez de recebê-las escritas por alguém. Em programação tradicional o sistema recebe regras mais dados e devolve respostas. Em machine learning ele recebe dados mais respostas conhecidas e devolve as regras, na forma de um conjunto de parâmetros ajustados durante o treino.
Qual a diferença entre inteligência artificial, machine learning e deep learning?
São círculos concêntricos. Inteligência artificial é o campo inteiro e inclui até sistemas de regras escritas à mão, sem aprendizado. Machine learning é o subconjunto em que o comportamento é aprendido de dados. Deep learning é o subconjunto do machine learning que usa redes neurais de muitas camadas, capazes de aprender direto de dado bruto como imagem, áudio e texto. Todo deep learning é machine learning, e todo machine learning é IA, mas o contrário não vale.
Quais são os tipos de aprendizado de máquina?
Três. No supervisionado, cada exemplo vem com a resposta certa, e ele cobre classificação, quando a resposta é uma categoria, e regressão, quando é um número. No não supervisionado, os dados não têm resposta e o algoritmo procura estrutura sozinho, agrupando ou detectando anomalias. No aprendizado por reforço não há resposta certa, há recompensa: o sistema tenta, recebe pontuação e ajusta a estratégia.
Qual a diferença entre aprendizado supervisionado e não supervisionado?
A presença do rótulo. No supervisionado, cada exemplo do treino vem acompanhado da resposta correta, e o modelo aprende a reproduzi-la em casos novos. No não supervisionado não existe resposta: o algoritmo encontra sozinho a estrutura dos dados, agrupando registros parecidos ou identificando o que destoa do padrão. A escolha não é preferência, é consequência do dado disponível.
Como um modelo de machine learning é treinado?
Prepara-se os dados, limpando e escolhendo as variáveis que entram. Separa-se em três conjuntos: treino, validação e teste, este último nunca visto pelo modelo. Treina-se, ajustando parâmetros para reduzir o erro entre a resposta produzida e a conhecida. Avalia-se no conjunto de teste com uma métrica definida antes. E monitora-se em produção, porque o desempenho cai com o tempo à medida que os dados novos deixam de parecer com os de treino.
O que é overfitting e underfitting?
São as duas formas simétricas de falhar. No overfitting o modelo decora o conjunto de treino, inclusive o ruído: acerta quase tudo no treino e erra feio em dado novo. No underfitting o modelo é simples demais para o padrão existente e vai mal nos dois. O overfitting é o mais perigoso porque se disfarça de sucesso, com números ótimos na apresentação e quebra no mundo real.
Por que a acurácia é uma métrica enganosa?
Porque falha quando as classes são desbalanceadas, que é o caso da maioria dos problemas úteis. Num sistema de detecção de fraude que ocorre em 1% das transações, um modelo que responde não é fraude para absolutamente tudo tem 99% de acurácia e não serve para nada. O número está certo e a conclusão está errada.
Qual a diferença entre precisão e recall?
Precisão responde: dos casos que apontei como positivos, quantos eram mesmo? É VP dividido por VP mais FP. Recall, ou sensibilidade, responde: dos positivos que existiam, quantos eu encontrei? É VP dividido por VP mais FN. As duas se opõem, e escolher entre elas é decisão de negócio. Em exame de doença grave o falso negativo é o erro caro, então prioriza-se recall. Em filtro de spam o falso positivo é o caro, então prioriza-se precisão.
Quando vale a pena usar machine learning?
Quando quatro condições aparecem juntas: existe padrão nos dados, a regra é difícil de escrever à mão mas fácil de exemplificar, há volume histórico com resposta conhecida, e errar às vezes é aceitável. Falhando uma delas, o custo raramente se paga. A terceira condição é a que mais derruba projetos, e diagnosticá-la no começo evita meses gastos.
Preciso de muitos dados para usar machine learning?
Sim, e esse costuma ser o gargalo real. O insumo do aprendizado supervisionado é histórico com resposta conhecida, e poucas dezenas de exemplos não sustentam um modelo. Vale lembrar também que o modelo aprende o que está nos dados, inclusive o que não deveria: histórico enviesado produz modelo enviesado, com a aparência de neutralidade que um número carrega.